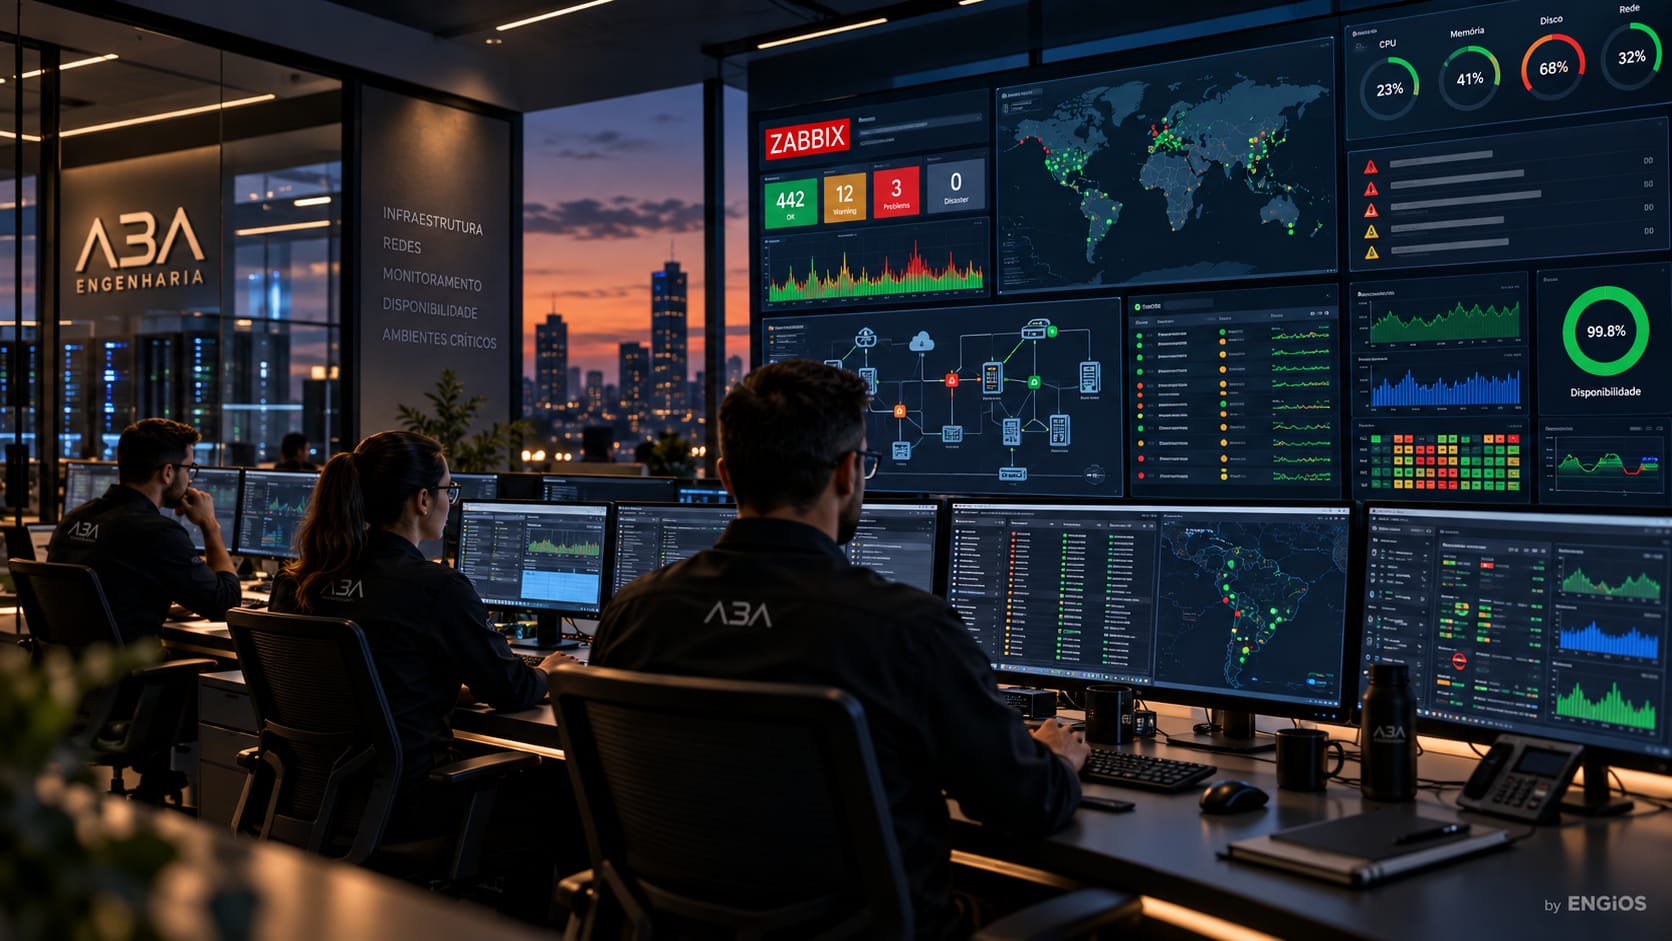
A solução Zabbix compreende a implantação, estruturação, integração e operação assistida de uma plataforma de monitoramento para infraestrutura de TI, redes, servidores, aplicações, serviços, data centers, ambientes industriais e operações críticas.
Em ambientes corporativos e industriais, a indisponibilidade de redes, servidores, links, serviços, aplicações e dispositivos pode impactar diretamente a operação. Por isso, o monitoramento não deve ser tratado apenas como visualização de alertas, mas como uma camada de governança operacional, rastreabilidade, diagnóstico e resposta técnica.
A A3A Engenharia estrutura o Zabbix como uma solução de monitoramento e observabilidade operacional, conectando coleta de dados, triggers, dashboards, mapas, alertas, indicadores, inventário, integrações e processos de resposta para ambientes que exigem confiabilidade e controle técnico.
Escopo, diagnóstico e implantação
No âmbito da solução Zabbix, a A3A Engenharia pode atuar nas seguintes frentes técnicas:
Diagnóstico e Arquitetura de Monitoramento.
- Levantamento da infraestrutura atual, ativos críticos, serviços monitoráveis e pontos de falha
- Definição da arquitetura de monitoramento para redes, servidores, aplicações, serviços e links
- Classificação de criticidade por ambiente, equipamento, serviço, unidade, site ou processo operacional
- Mapeamento de dependências entre infraestrutura, sistemas, conectividade e operação
- Definição de indicadores, thresholds, triggers, notificações e regras de escalonamento
Implantação e Configuração do Zabbix.
- Instalação, configuração inicial e estruturação da plataforma conforme o ambiente do cliente
- Configuração de hosts, grupos, templates, itens, triggers, dashboards, mapas e ações
- Monitoramento por agentes, SNMP, ICMP, HTTP, APIs, scripts, traps e integrações específicas
- Organização de usuários, permissões, perfis, grupos operacionais e visões por área
- Padronização de nomenclatura, severidades, mensagens, tags e categorias de eventos
Operação Assistida, Governança e Integrações.
- Criação de rotinas para revisão de alertas, tuning de triggers e redução de ruído operacional
- Integração com ferramentas de ITSM, comunicação, inventário, automação e documentação técnica
- Estruturação de painéis executivos, painéis técnicos e visões por serviço ou ambiente
- Apoio à definição de procedimentos de resposta, escalonamento e registro de incidentes
- Acompanhamento de maturidade, melhoria contínua e governança do monitoramento
Riscos, lacunas e requisitos que orientam a solução.
O Zabbix é indicado para organizações que precisam sair de uma operação reativa para uma gestão mais observável, estruturada e orientada a eventos técnicos.
- Falhas de rede, servidores ou serviços identificadas apenas após reclamação do usuário
- Ausência de visibilidade sobre disponibilidade, desempenho, latência, consumo e capacidade
- Alertas excessivos, pouco classificados ou sem contexto operacional
- Dificuldade para acompanhar ambientes multisite, data centers, unidades remotas e redes críticas
- Baixa rastreabilidade entre eventos, causas, impactos, ações e histórico de incidentes
- Dashboards técnicos inexistentes ou desconectados da criticidade real da operação
- Dependência de verificações manuais para entender a saúde da infraestrutura
Principais capacidades técnicas.
Monitoramento de rede.
O Zabbix permite monitorar switches, roteadores, firewalls, access points, links, interfaces, disponibilidade, tráfego, erros, latência, perda de pacotes, status de portas, consumo de banda e demais variáveis relevantes para operação de redes corporativas e ambientes críticos.
Monitoramento de servidores e sistemas.
A plataforma pode monitorar servidores físicos, virtuais, sistemas operacionais, serviços, processos, recursos de CPU, memória, disco, disponibilidade, logs, aplicações, bancos de dados e componentes críticos da infraestrutura de TI.
Monitoramento SNMP, agentes, APIs e serviços.
O Zabbix suporta diferentes formas de coleta, permitindo monitoramento por agentes, SNMP, ICMP, HTTP, APIs, scripts, traps e integrações específicas. Essa flexibilidade permite cobrir desde ativos de rede até aplicações, serviços e equipamentos especializados.
Dashboards, mapas e alertas.
Dashboards, mapas, telas e alertas permitem acompanhar a saúde operacional da infraestrutura. Quando bem estruturados, esses recursos reduzem ruído, melhoram a priorização e ajudam equipes técnicas a responder com mais contexto.
Observabilidade operacional.
Embora o Zabbix seja tradicionalmente reconhecido como ferramenta de monitoramento, sua aplicação em ambientes críticos pode compor uma estratégia mais ampla de observabilidade operacional, conectando métricas, eventos, disponibilidade, desempenho, histórico e resposta técnica.
Arquitetura da plataforma e coleta de dados
A arquitetura deve ser dimensionada conforme quantidade de hosts, itens, frequência de coleta, volume de eventos, retenção e distribuição geográfica. Em ambientes maiores, server, proxies, banco de dados e front-end podem assumir papéis distintos para reduzir latência de coleta e evitar concentração desnecessária de tráfego.
Proxies são especialmente úteis em sites remotos, redes segmentadas e ambientes industriais. Eles permitem coletar dados localmente e encaminhá-los ao servidor central, reduzindo dependência de conectividade contínua e simplificando regras de firewall.
O banco de dados é componente crítico. Housekeeping, retenção, tendências, frequência de atualização e cardinalidade de itens influenciam diretamente capacidade de armazenamento e desempenho.
Modelagem de ativos, serviços e dependências
Hosts isolados não representam necessariamente o serviço percebido pelo usuário. Um serviço pode depender de switch, firewall, DNS, servidor, banco de dados, aplicação e link externo. O monitoramento precisa relacionar esses componentes para evitar dezenas de alarmes independentes quando uma única dependência falha.
Grupos, tags, templates e mapas devem refletir critérios operacionais como site, criticidade, cliente, serviço, domínio tecnológico e responsabilidade.
Templates, itens e descoberta automática.
Templates devem concentrar lógica reutilizável de itens, triggers, macros e discovery. O objetivo é reduzir configurações host a host e permitir evolução controlada. Templates genéricos demais podem produzir ruído; templates excessivamente específicos aumentam manutenção.
Low-Level Discovery permite identificar interfaces, filesystems, sensores, processos ou outros objetos de forma dinâmica. Filtros e protótipos precisam limitar elementos irrelevantes e impedir explosão de itens.
Uma plataforma de monitoramento só produz valor quando modela dependências reais.
Itens, triggers e mapas devem representar criticidade, correlação e impacto sobre serviços. Sem engenharia dos eventos, a operação recebe alarmes em excesso e perde capacidade de priorização.
Métodos de coleta, normalização e descoberta
SNMP é amplamente utilizado para redes, UPS, climatização, energia e dispositivos especializados. SNMPv3 adiciona autenticação e privacidade e deve ser preferido quando suportado.
Agentes permitem coleta mais profunda de sistema operacional e aplicações. Active checks podem ser úteis quando conexões de entrada são restritas. Traps ajudam em eventos assíncronos, mas precisam ser combinadas com polling para evitar dependência exclusiva de mensagens que podem ser perdidas.
APIs e scripts ampliam cobertura para serviços sem integração nativa. Essas extensões precisam ter timeout, tratamento de erro e controle de credenciais para que o próprio monitoramento não introduza carga ou vulnerabilidades.
Alertas, severidade e redução de ruído
Thresholds precisam refletir comportamento real. Um valor instantâneo acima de limite não significa necessariamente falha. Médias, janelas, funções de tendência e hysteresis podem evitar alarmes que abrem e fecham repetidamente ao redor do limiar.
Triggers também precisam considerar dependências. Se um roteador de borda está indisponível, alertas dos dispositivos atrás dele podem ser suprimidos ou correlacionados para reduzir ruído.
Severidade, ownership e escalonamento.
Severidade deve representar impacto, não apenas tipo técnico do evento. CPU elevada em servidor de laboratório pode ter criticidade menor que perda de um serviço central. Tags e grupos podem direcionar alertas para equipes diferentes conforme responsabilidade.
Escalonamentos devem definir canais, horários, responsáveis e ausência de resposta. Alertas sem owner claro tendem a permanecer abertos ou ser tratados informalmente.
Capacidade, tendência e previsão.
O histórico não serve apenas para incidentes. Crescimento de disco, utilização de links, consumo de memória, temperatura e ocupação de recursos podem indicar aproximação de limites antes que a falha ocorra.
Tendências precisam considerar sazonalidade e picos. Uma média mensal pode esconder saturações recorrentes em períodos específicos.
Rede, serviços, SLA e capacidade
Além de disponibilidade, switches e roteadores podem ser acompanhados por utilização, erros, descartes, flaps, temperatura, CPU, memória, estado de fontes e módulos. Interfaces críticas devem possuir baseline e contexto para distinguir saturação legítima de degradação.
Latência, perda e jitter podem ser relevantes em voz, vídeo, enlaces WAN e aplicações sensíveis. ICMP isolado não representa toda a experiência, mas compõe um conjunto de sinais úteis quando interpretado junto a tráfego e eventos.
Ambientes IT/OT e redes industriais.
Em ambientes industriais, a coleta precisa respeitar criticidade e segurança da rede OT. Polling agressivo, scripts não validados ou credenciais excessivas podem introduzir risco. A arquitetura deve priorizar protocolos e métodos suportados pelos ativos.
Monitorar switches industriais, gateways, servidores SCADA e serviços de infraestrutura pode fornecer visibilidade sem interferir no processo de controle.
Alta disponibilidade, segurança e continuidade
Em operações críticas, o próprio Zabbix não deve se tornar ponto único de falha. Banco, server, proxies, front-end e mecanismos de notificação precisam ser avaliados quanto a disponibilidade e recuperação.
Backup deve incluir configurações, banco e componentes necessários à reconstrução. Testes de restauração são importantes porque monitoramento costuma ser mais necessário durante incidentes amplos.
Segurança da plataforma.
Usuários, perfis, APIs, agentes e credenciais de SNMP ou sistemas externos precisam seguir menor privilégio. Segredos não devem ser expostos em macros acessíveis indiscriminadamente ou scripts sem proteção.
Comunicação entre componentes deve ser protegida quando suportado, e interfaces administrativas precisam ficar restritas a redes e perfis adequados.
Integrações, automação e operação
Eventos podem abrir tickets, enviar mensagens, acionar webhooks ou iniciar automações. A integração deve evitar que todo alerta gere automaticamente um incidente sem classificação, pois isso apenas desloca ruído para outra ferramenta.
Integração com inventário ou fonte de verdade ajuda a manter contexto de ativos, localização e responsabilidade.
Dashboards orientados a serviço.
Dashboards técnicos podem mostrar métricas detalhadas; dashboards executivos devem sintetizar disponibilidade, incidentes, capacidade e risco. Misturar todos os indicadores em uma única tela reduz clareza.
Uma visão de serviço deve responder se a função está disponível e quais dependências estão degradadas.
Ciclo de vida, governança e evolução
- Discovery: ativos, serviços, dependências e criticidade.
- Arquitetura: server, proxies, banco, rede e segurança.
- Modelagem: grupos, tags, templates, itens e triggers.
- Implantação: agentes, SNMP, APIs, dashboards e alertas.
- Homologação: simulação de falhas e validação de notificações.
- Tuning: redução de ruído e ajuste de thresholds.
- Operação: incidentes, capacidade, relatórios e governança.
- Evolução: novos ativos, integrações, templates e automações.
Disponibilidade precisa ser demonstrada na cadeia de coleta e resposta.
O aceite deve testar agentes, proxies, comunicação, retenção, escalonamento e recuperação após perda de conectividade, além da configuração de dashboards.
Testes, aceite e documentação operacional
O aceite deve comprovar descoberta e coleta dos ativos previstos, atualização dentro da frequência definida, geração correta de triggers, recebimento das notificações e representação adequada nos dashboards.
Falhas simuladas podem incluir perda de link, serviço parado, utilização acima do limite, indisponibilidade de host e recuperação. O importante é validar a cadeia completa: detecção, classificação, notificação, reconhecimento e encerramento.
Documentação operacional.
A documentação deve incluir arquitetura, inventário monitorado, templates, macros, regras de severidade, canais de notificação, dependências, procedimentos de backup e runbooks.
Alterações relevantes em thresholds, templates e ações precisam ser controladas. O monitoramento é parte da infraestrutura operacional e deve possuir governança de configuração.
Aplicações e ambientes
A solução Zabbix pode ser aplicada a diferentes contextos de infraestrutura tecnológica:
- Redes corporativas, LAN, WAN, Wi-Fi e ambientes multisite
- Data centers, salas técnicas e infraestrutura de servidores
- Ambientes industriais e redes IT/OT
- Provedores, integradores, NOCs e operações com múltiplos clientes ou unidades
- Sistemas de segurança eletrônica IP, CFTV, controle de acesso e serviços críticos de rede
- Organizações que precisam de rastreabilidade, disponibilidade e governança operacional
Banco de dados, retenção e performance da plataforma.
Histórico detalhado e trends possuem comportamentos diferentes de armazenamento. Frequências de coleta muito curtas multiplicam volume e I/O; retenções longas elevam custo sem necessariamente agregar valor. A arquitetura deve definir quanto tempo cada classe de métrica precisa permanecer em granularidade completa.
Housekeeping, particionamento e capacidade do banco influenciam diretamente desempenho. Crescimento descontrolado pode tornar consultas e manutenção lentas justamente quando o histórico é necessário para investigar incidentes.
Monitoramento por serviço e SLA.
A disponibilidade de um serviço deve ser derivada de seus componentes críticos e das condições realmente percebidas. Um servidor respondendo ICMP não demonstra que autenticação, banco e aplicação estejam funcionais.
Indicadores de SLA podem ser calculados a partir de eventos e períodos de indisponibilidade, desde que regras de manutenção, dependências e exceções estejam definidas. Métricas sem governança podem produzir números formalmente precisos, porém operacionalmente enganosos.
Manutenções planejadas e supressão controlada.
Janelas de manutenção devem impedir alarmes previsíveis sem ocultar falhas não relacionadas. Escopo, duração e ativos envolvidos precisam ser controlados. Supressões permanentes para eliminar ruído mascaram problemas em vez de resolvê-los.
Monitoramento sintético e disponibilidade funcional.
Web scenarios, verificações HTTP e scripts podem simular partes da jornada de um usuário. Login, consulta, API ou download podem ser testados periodicamente para detectar falhas que métricas de infraestrutura não mostram.
Esses testes devem ser leves, previsíveis e executados com contas ou dados apropriados para não gerar efeitos operacionais indesejados.
Governança de mudanças no monitoramento.
Novos templates, triggers e macros podem afetar centenas de hosts. Mudanças precisam ser revisadas, testadas em grupo controlado e documentadas antes de propagação ampla.
É útil manter convenções de nomenclatura, severidade, tags e ownership. Sem padrão, ambientes maduros tendem a acumular exceções difíceis de sustentar.
Indicadores de qualidade do próprio monitoramento.
A plataforma também deve ser medida: itens unsupported, hosts sem dados, filas de coleta, atrasos, taxa de falso positivo, alertas sem owner e eventos repetitivos ajudam a identificar degradação da própria solução.
Monitorar o monitoramento evita falsa sensação de cobertura. Um host cadastrado mas sem atualização recente não representa ativo efetivamente observado.
Modos de falha recorrentes.
- templates copiados sem adaptação ao ambiente;
- triggers baseadas em limiares arbitrários;
- alertas sem dependência ou correlação;
- retenção excessiva degradando o banco;
- SNMP communities compartilhadas e sem governança;
- proxies sem capacidade ou sem fila monitorada;
- dashboards sem relação com serviços críticos;
- manutenções usadas para esconder alarmes persistentes;
- hosts cadastrados sem owner;
- integrações que abrem tickets para qualquer evento.
Operação e considerações de engenharia
Mais itens não significam melhor monitoramento. Cada métrica precisa responder a uma pergunta operacional, apoiar diagnóstico, capacidade ou evidência. Coleta sem finalidade aumenta ruído e custo.
O Zabbix também não substitui observabilidade completa de aplicações. Logs estruturados e tracing distribuído podem exigir plataformas complementares. O desenho deve definir o papel de cada ferramenta.
Capacity planning da própria plataforma.
A capacidade do Zabbix precisa crescer junto com o ambiente monitorado. Quantidade de values per second, filas, pollers, preprocessors, proxies e desempenho do banco devem ser acompanhados para evitar que a plataforma se torne o gargalo.
Expansões de sites ou aquisição de grandes quantidades de equipamentos devem ser avaliadas antes da inclusão em massa. O impacto depende não apenas do número de hosts, mas do número de itens e da frequência de coleta.
Preprocessing e normalização de dados.
Preprocessing pode converter unidades, filtrar valores, interpretar JSON ou XML, calcular deltas e descartar informações sem utilidade. Essa camada ajuda a normalizar dados de fabricantes diferentes e reduzir armazenamento desnecessário.
Transformações precisam ser documentadas porque alteram o significado do valor armazenado. Uma métrica derivada deve deixar claro sua origem, unidade e regra de cálculo.
Relação com NOC, operação e resposta a incidentes.
Em NOCs, o Zabbix pode compor a camada de detecção e contexto operacional, mas a resposta depende de processos, ownership e escalonamento. Um alerta útil deve indicar o ativo, o sintoma, a criticidade e informações suficientes para o primeiro diagnóstico.
Runbooks podem vincular eventos recorrentes a procedimentos de verificação e recuperação. Essa padronização reduz dependência de conhecimento individual e melhora consistência entre turnos.
Zabbix não é apenas uma ferramenta de alerta.
Um ambiente Zabbix mal estruturado pode se tornar apenas uma central de alarmes ruidosa. O valor da solução está na engenharia do monitoramento: seleção correta de itens, thresholds coerentes, templates bem mantidos, severidades adequadas, mapas úteis, dashboards orientados à operação e processos claros de resposta.
Por isso, a implantação do Zabbix deve considerar arquitetura, governança, criticidade, documentação, integração e operação contínua. A plataforma precisa refletir a realidade técnica do ambiente e apoiar decisões operacionais, não apenas emitir notificações.
Benefícios esperados.
- Maior visibilidade sobre disponibilidade, desempenho e capacidade da infraestrutura
- Redução do tempo de identificação de falhas, degradações e indisponibilidades
- Melhor priorização de incidentes conforme criticidade operacional
- Dashboards técnicos e executivos mais aderentes à realidade do ambiente
- Base histórica para análise de tendência, capacidade e recorrência de eventos
- Integração do monitoramento com documentação, inventário, automação e processos de resposta
- Maior governança sobre redes, servidores, serviços, aplicações e ambientes críticos
Serviços que materializam a solução
A A3A Engenharia atua com projetos, implantação, diagnóstico, documentação, certificação e governança de infraestrutura tecnológica. Nesse contexto, o Zabbix complementa a engenharia de redes, servidores, segurança eletrônica IP e ambientes críticos ao criar uma camada contínua de monitoramento e visibilidade operacional.
A solução pode ser integrada a projetos de redes corporativas, cabeamento estruturado, backbone óptico, Wi-Fi, data centers, CFTV IP, controle de acesso, segurança eletrônica, servidores, serviços críticos e operações que dependem de disponibilidade e rastreabilidade técnica.
Diagnóstico de Monitoramento e Observabilidade.
A adoção do Zabbix deve começar por um diagnóstico do ambiente: ativos críticos, serviços essenciais, dependências, pontos de falha, visões operacionais, regras de alerta, responsáveis, integrações e nível atual de maturidade do monitoramento.
A A3A Engenharia pode apoiar essa jornada com diagnóstico, arquitetura, implantação assistida, padronização de templates, saneamento de alertas, dashboards, integrações, treinamento e estruturação de governança para uso contínuo do Zabbix.
Estruture o monitoramento antes de multiplicar sensores e alertas.
O diagnóstico identifica ativos, serviços, limiares, responsáveis e procedimentos de resposta para dimensionar a implantação do Zabbix e seus critérios de validação.