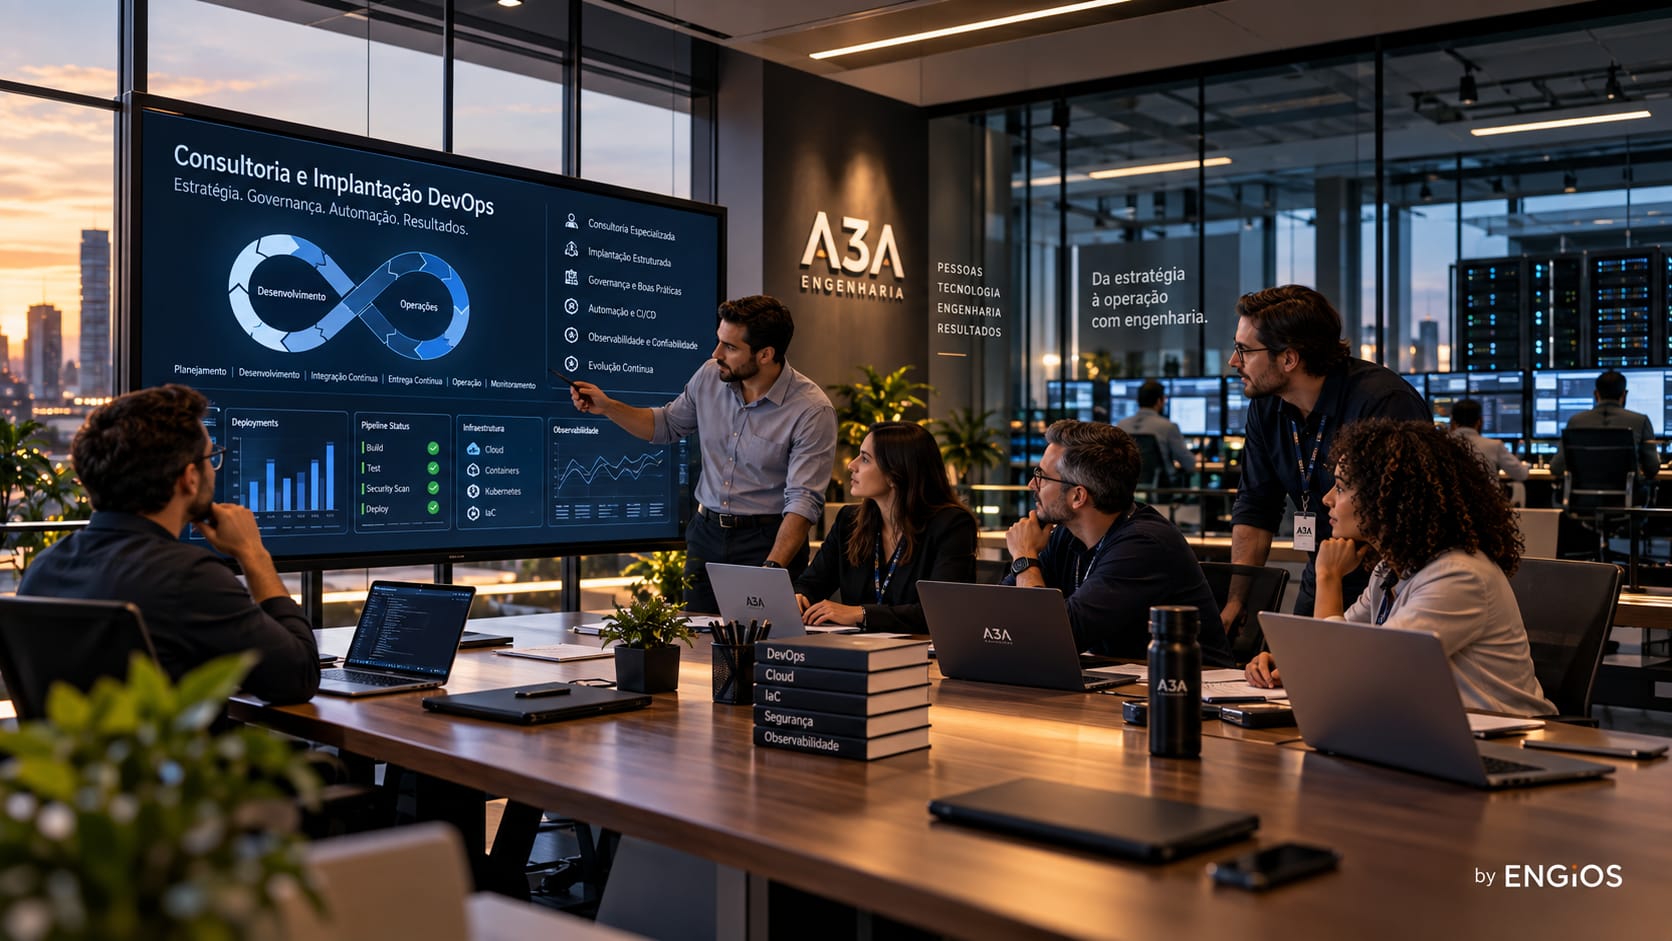
A Consultoria e Implantação DevOps estrutura a integração entre desenvolvimento, infraestrutura, segurança e operação para reduzir tempo de entrega sem perder controle técnico. O objetivo não é simplesmente instalar ferramentas de automação, mas criar um sistema de trabalho em que mudanças possam ser planejadas, testadas, promovidas, observadas e recuperadas de forma previsível.
Em organizações com baixa maturidade, código, ambientes, deploys, configuração e operação costumam depender de processos distintos e conhecimento individual. Desenvolvimento entrega uma versão, infraestrutura prepara manualmente o ambiente, segurança avalia tardiamente e operação recebe a mudança sem contexto suficiente. Esse modelo aumenta lead time, retrabalho, falhas em produção e dificuldade de identificar responsabilidade sobre cada transição.
DevOps deve ser tratado como uma arquitetura sociotécnica: processos, papéis, automação, plataforma, observabilidade, segurança e métricas precisam evoluir juntos. Automatizar um fluxo mal definido ou introduzir uma ferramenta sem ajustar responsabilidades apenas transfere gargalos para outra camada.
A solução parte do estado atual, define um modelo-alvo e estabelece um roadmap progressivo. A implantação pode combinar CI/CD, containers, infraestrutura como código, automação de configuração, observabilidade, gestão de secrets, padrões de release, ambientes, qualidade e governança de mudanças.
| Condição observada | Risco ou limitação | Resposta de engenharia |
|---|---|---|
| Deploys manuais e dependentes de pessoas específicas | Variabilidade, baixa frequência de entrega e falhas de procedimento | Pipeline versionado, automação e responsabilidades explícitas |
| Ambientes são configurados de formas diferentes | Erros difíceis de reproduzir e homologação pouco confiável | IaC, configuração automatizada e artefatos promovidos entre ambientes |
| Segurança entra apenas antes da produção | Vulnerabilidades e retrabalho detectados tardiamente | Controles de segurança distribuídos no ciclo de entrega |
| Operação recebe mudança sem telemetria adequada | Diagnóstico lento e maior tempo de recuperação | Observabilidade, health checks, alertas e runbooks |
| Equipes adotam ferramentas diferentes sem padrão | Fragmentação, duplicidade e custo operacional | Arquitetura de referência, padrões reutilizáveis e governança de plataforma |
Arquitetura da solução DevOps
A arquitetura precisa conectar o fluxo desde a demanda até a operação. Repositório de código, gestão de branches, build, testes, artefatos, ambientes, infraestrutura, secrets, deploy, observabilidade e incidentes formam uma cadeia única. O desenho deve identificar onde existem handoffs, esperas, retrabalho e controles manuais.
Não existe uma topologia universal. Produtos SaaS, aplicações internas, workloads regulados, microsserviços e sistemas legados possuem requisitos diferentes. A arquitetura deve considerar criticidade, frequência de mudança, quantidade de equipes, dependências e capacidade operacional.
O modelo-alvo também precisa definir quais capacidades serão centralizadas e quais permanecem com os times. Templates de pipeline, imagens base, módulos de infraestrutura, observabilidade e padrões de segurança podem ser fornecidos como capacidades compartilhadas, enquanto cada produto mantém autonomia sobre seu ciclo funcional.
Assessment de maturidade e fluxo de valor
Mapeamento do fluxo atual
O diagnóstico deve acompanhar uma mudança real desde a solicitação até produção. É necessário registrar tempos de espera, aprovações, atividades manuais, retrabalho, ferramentas, dependências e pontos onde informação se perde. A análise do fluxo real costuma revelar gargalos que não aparecem em procedimentos formais.
Lead time não deve ser interpretado apenas como tempo de execução técnica. Filas para revisão, disponibilidade de ambiente, dependência de terceiros e janelas de mudança podem representar parcela maior do ciclo que o próprio desenvolvimento.
Maturidade por capacidade
A avaliação pode ser organizada por capacidades como versionamento, build, testes, release, infraestrutura, segurança, observabilidade, incidentes e governança. Uma média global tende a esconder assimetrias: uma empresa pode possuir CI/CD avançado, mas ainda configurar produção manualmente.
O objetivo do assessment não é atribuir uma nota isolada, mas identificar quais lacunas realmente limitam desempenho ou aumentam risco. O roadmap deve priorizar capacidades com maior efeito sistêmico.
DevOps não começa pela ferramenta; começa pelo fluxo e pelos controles que precisam ser melhorados.
Automação gera mais valor quando elimina variabilidade, preserva rastreabilidade e reduz esperas entre equipes.
CI/CD, testes e qualidade
A integração contínua reduz o intervalo entre alteração e feedback. Builds reproduzíveis, testes automatizados e análise estática ajudam a identificar problemas antes da promoção. O pipeline precisa possuir gates proporcionais ao risco e produzir evidências associadas à versão entregue.
Entrega contínua não implica publicação automática em todos os cenários. Ambientes críticos podem exigir aprovação humana ou janela controlada. A maturidade está em tornar a decisão explícita e repetível, e não necessariamente em eliminar todos os pontos de autorização.
A solução de CI/CD e Automação de Pipelines aprofunda arquitetura de build, testes, registries, quality gates, estratégias de release e rollback.
Infraestrutura como código e configuração
Ambientes consistentes dependem de definição reproduzível. Recursos de infraestrutura podem ser descritos por código, revisados e aplicados por pipeline. A Infraestrutura como Código reduz dependência de mudanças manuais e permite identificar drift entre estado esperado e estado real.
Configuração de sistemas também precisa de controle. Aplicar IaC sem governar parâmetros, packages, hardening e configuração de serviços deixa uma parcela relevante da variabilidade fora do modelo. A Automação de Infraestrutura complementa essa camada.
O desenho deve definir módulos reutilizáveis, revisão, state, segregação de ambientes, permissões e processo de mudança. Automação com credenciais amplas e sem revisão pode aumentar risco em vez de reduzi-lo.
Containers, plataformas e experiência do desenvolvedor
A Containerização de Aplicações pode padronizar runtime e melhorar portabilidade, mas exige decisões sobre imagens, persistência, redes, secrets e observabilidade. Em ambientes maiores, capacidades recorrentes podem ser oferecidas por uma plataforma interna.
Engenharia de plataforma busca transformar infraestrutura e processos operacionais em serviços reutilizáveis. Portais internos, templates e self-service reduzem carga cognitiva dos times de produto quando fornecem caminhos seguros e suportados para tarefas frequentes.
O objetivo não é centralizar todas as decisões, mas estabelecer um “paved road” que facilite fazer o certo por padrão. Exceções continuam possíveis, porém precisam ser justificadas quando aumentam custo ou risco.
DevSecOps, identidade e gestão de secrets
Segurança deve acompanhar todo o ciclo de mudança. SAST, análise de dependências, scan de imagens, políticas, revisão de permissões e validação de secrets podem ser integrados aos pipelines. O objetivo é mover detecção para momentos em que correções ainda são baratas.
Os próprios pipelines são ativos críticos. Runners, tokens, registries e integrações com cloud precisam aplicar menor privilégio, segregação e credenciais de curta duração quando possível. Uma credencial de automação excessivamente privilegiada pode ampliar o impacto de comprometimento.
Gates de segurança também precisam possuir lógica de exceção. Vulnerabilidades sem exploração prática podem receber tratamento diferente de falhas críticas expostas; o processo precisa registrar decisão e risco residual.
Observabilidade, incidentes e feedback operacional
DevOps fecha o ciclo quando informação de produção retorna para desenvolvimento. Métricas, logs, traces, erros e eventos de negócio ajudam a avaliar se a mudança produziu o comportamento esperado. A Observabilidade de Sistemas e Aplicações estrutura essa capacidade.
Deploy bem-sucedido no pipeline não significa serviço saudável. Validações pós-deploy, SLOs, alertas e testes sintéticos podem orientar rollback ou investigação. O vínculo entre versão e telemetria permite localizar regressões mais rapidamente.
Incidentes também devem retroalimentar o sistema. Postmortems sem culpabilização, ações corretivas e atualização de runbooks transformam falhas em melhorias concretas de arquitetura e processo.
Métricas e melhoria contínua
Métricas como frequência de deploy, tempo de mudança, taxa de falha e tempo de recuperação podem apoiar diagnóstico do fluxo. Entretanto, nenhuma delas deve ser utilizada isoladamente como meta universal. A interpretação precisa considerar criticidade, tipo de produto e contexto.
Indicadores também podem acompanhar duração de pipeline, flakiness de testes, tempo de espera por ambiente, quantidade de mudanças manuais e incidentes relacionados a release. O objetivo é localizar desperdício e risco, não apenas produzir dashboard.
A melhoria deve ocorrer em ciclos curtos: medir, identificar gargalo, alterar processo ou plataforma e verificar se o resultado melhorou. Roadmaps rígidos de longa duração tendem a perder aderência às mudanças do ambiente.
Ciclo de vida da implantação
A implantação começa pelo diagnóstico e seleção de um fluxo-piloto. Em seguida são definidos arquitetura alvo, prioridades, padrões e indicadores. O piloto deve ser suficientemente representativo para validar integração entre desenvolvimento, infraestrutura, segurança e operação.
Depois da estabilização, componentes reutilizáveis podem ser transformados em templates e padrões corporativos. A expansão deve preservar autonomia suficiente para diferentes produtos sem criar dezenas de exceções incompatíveis.
Treinamento e transferência de conhecimento são parte da solução. Uma plataforma DevOps que depende permanentemente da equipe que a implantou não atingiu maturidade operacional.
Verificação e critérios de aceite
O aceite deve comprovar que mudanças percorrem o fluxo esperado e que os mecanismos de falha foram testados. Build quebrado, teste reprovado, credencial ausente, indisponibilidade do registry, falha de deploy e rollback são cenários relevantes.
Também deve ser verificado se logs e evidências permitem reconstruir qual código foi publicado, qual artefato foi utilizado, quais gates foram aprovados e quem autorizou a promoção quando existe aprovação manual.
Entregáveis podem incluir assessment, mapa de fluxo de valor, arquitetura DevOps, padrões de repositório, pipelines, templates, modelo de ambientes, políticas de segurança, observabilidade, runbooks, roadmap e plano de capacitação.
Estratégia de ambientes, releases e mudanças
A topologia de ambientes precisa refletir risco e forma de entrega. Desenvolvimento, integração, homologação, pré-produção e produção não precisam existir sempre como ambientes permanentes, mas as funções de validação que representam precisam estar cobertas. Ambientes efêmeros podem reduzir filas em alguns cenários; sistemas integrados ou dependentes de dados complexos podem exigir ambientes compartilhados e controlados.
Release e deploy também precisam ser distinguidos. O deploy altera tecnicamente o ambiente; o release disponibiliza uma capacidade para uso. Feature flags, rollout gradual e janelas de ativação permitem desacoplar essas decisões quando o produto exige maior controle.
A governança de mudanças deve ser proporcional. Mudanças padronizadas, automatizadas e reversíveis podem seguir fluxo simplificado, enquanto alterações de alto impacto exigem análise adicional. O objetivo é reduzir burocracia sem abrir mão de rastreabilidade e responsabilidade.
Modelo operacional entre desenvolvimento e operação
DevOps não significa eliminar especialidades. Desenvolvimento, plataforma, infraestrutura, segurança e operação continuam possuindo competências distintas. O modelo operacional precisa definir interfaces e ownership de serviços, pipelines, infraestrutura, observabilidade e incidentes.
Responsabilidade compartilhada não deve significar responsabilidade difusa. Serviços precisam possuir owner, critérios de suporte e limites claros. Quando ninguém sabe quem responde por uma falha de pipeline ou por uma configuração de produção, a automação não resolveu o problema organizacional.
Catálogos de serviço, padrões internos e runbooks podem formalizar essas interfaces. A evolução para engenharia de plataforma pode ocorrer quando a organização possui escala suficiente para oferecer capacidades comuns como produto interno.
Governança de ferramentas e arquitetura de referência
À medida que a organização amadurece, o próprio ecossistema DevOps precisa de governança. Repositórios, runners, registries, plataformas de observabilidade, cofres de secrets e ferramentas de análise possuem custo, ciclo de atualização e integrações que precisam ser administrados. A proliferação de ferramentas equivalentes aumenta suporte e reduz reutilização.
Uma arquitetura de referência pode definir padrões preferenciais, critérios de exceção e componentes reutilizáveis sem bloquear inovação. O objetivo é reduzir decisões repetitivas e tornar integrações comuns — autenticação, logging, artefatos, segurança e deploy — disponíveis de forma consistente.
Essa governança também precisa evitar lock-in desnecessário. Pipelines, artefatos e configurações devem ser estruturados de modo que decisões de ferramenta possam evoluir sem reconstruir completamente o processo de entrega.
Considerações de Engenharia
Ferramenta não substitui processo
Adotar uma suíte de CI/CD sem definir fluxo, responsabilidade e critérios pode apenas automatizar inconsistências existentes.
Mais automação pode aumentar o raio de impacto
Um erro manual tende a ser localizado; um erro automatizado pode ser reproduzido em escala. Revisão, testes e segregação continuam necessários.
Velocidade e estabilidade não são objetivos opostos
Feedback rápido, releases menores e rollback previsível podem reduzir simultaneamente risco e tempo de entrega quando a arquitetura está bem estruturada.
Padronização deve reduzir carga cognitiva
Padrões que exigem exceções constantes perdem valor. O caminho recomendado precisa cobrir a maioria dos casos e ser mais simples que soluções paralelas.
Aplicações e soluções que materializam a estratégia
A solução é aplicável a equipes de software, plataformas digitais internas, produtos SaaS, modernização cloud e ambientes com múltiplos sistemas e ciclos frequentes de mudança. Também pode ser usada em organizações que já possuem ferramentas DevOps, mas não obtêm consistência entre equipes.
A implementação se conecta a CI/CD, Containerização, IaC, Automação de Infraestrutura, Observabilidade e Engenharia de Plataforma.
DevOps maduro é um sistema de entrega e operação confiável, não uma coleção de ferramentas.
O resultado esperado é reduzir variabilidade, encurtar feedback e tornar mudanças rastreáveis, observáveis e recuperáveis.
Modelo de contratação
O trabalho pode começar por assessment independente, projeto-piloto ou programa de transformação. O escopo é definido conforme número de aplicações, equipes, ambientes e maturidade atual.
A implantação pode ocorrer por ondas, priorizando capacidades de maior efeito: CI/CD, ambientes, IaC, containers, observabilidade, segurança ou plataforma. Cada onda precisa possuir critérios de aceite e indicadores que demonstrem evolução real.
O resultado esperado é uma arquitetura operacional que a própria organização consiga sustentar, evoluir e aplicar a novos produtos com menor dependência de intervenções manuais.
Precisa reduzir gargalos de entrega ou padronizar práticas DevOps entre equipes?
A A3A Engenharia pode diagnosticar o fluxo atual, estruturar o modelo-alvo e implantar progressivamente automação, observabilidade e governança.
Continue pela jornada técnica: CI/CD · Engenharia de Plataforma · Artigo sobre Docker · Guia Completo sobre HTTP · Paper sobre automação e fonte da verdade.