CI/CD e automação de pipelines de software estruturam a passagem do código-fonte até ambientes de teste, homologação e produção por meio de etapas repetíveis, verificáveis e controladas. O objetivo não é apenas acelerar deploys, mas reduzir variabilidade, registrar evidências e impedir que mudanças avancem sem atender critérios técnicos definidos.
Em operações manuais, build, testes, empacotamento, publicação e configuração podem depender de conhecimento individual e procedimentos não documentados. Isso cria diferenças entre execuções, aumenta o risco de erro humano e dificulta responder perguntas básicas: qual commit gerou o artefato publicado? Quais testes foram executados? Quem aprovou a promoção? Quais variáveis e dependências estavam presentes? Como reverter com segurança?
Um pipeline maduro trata a entrega de software como um sistema de engenharia. Código, dependências, artefatos, ambientes, credenciais, critérios de qualidade e mecanismos de rollback precisam formar uma cadeia rastreável. A automação deve eliminar tarefas repetitivas, mas preservar controles onde existe risco técnico, operacional ou de segurança.
A solução precisa ser desenhada conforme arquitetura da aplicação, criticidade, frequência de mudança, estratégia de branches, ambientes disponíveis, requisitos de segurança e capacidade operacional. Não existe um pipeline universal: o desenho adequado para uma aplicação web simples é diferente daquele necessário para microsserviços, sistemas regulados ou plataformas de missão crítica.
| Condição observada | Risco técnico | Resposta de engenharia |
|---|---|---|
| Build e deploy executados manualmente | Execuções diferentes, dependência de pessoas e erros de procedimento | Pipeline como código, etapas determinísticas e logs de execução |
| Artefato é recompilado em cada ambiente | Produção pode receber binário diferente do homologado | Artefato imutável promovido entre ambientes |
| Testes são opcionais ou executados depois do deploy | Defeitos avançam antes da detecção | Quality gates e verificações antes da promoção |
| Credenciais ficam em arquivos ou variáveis expostas | Vazamento, uso indevido e dificuldade de rotação | Gestão de segredos, identidade de workload e menor privilégio |
| Rollback depende de intervenção improvisada | Maior indisponibilidade durante falhas | Versionamento, estratégia de implantação e reversão testada |
Arquitetura de um pipeline CI/CD
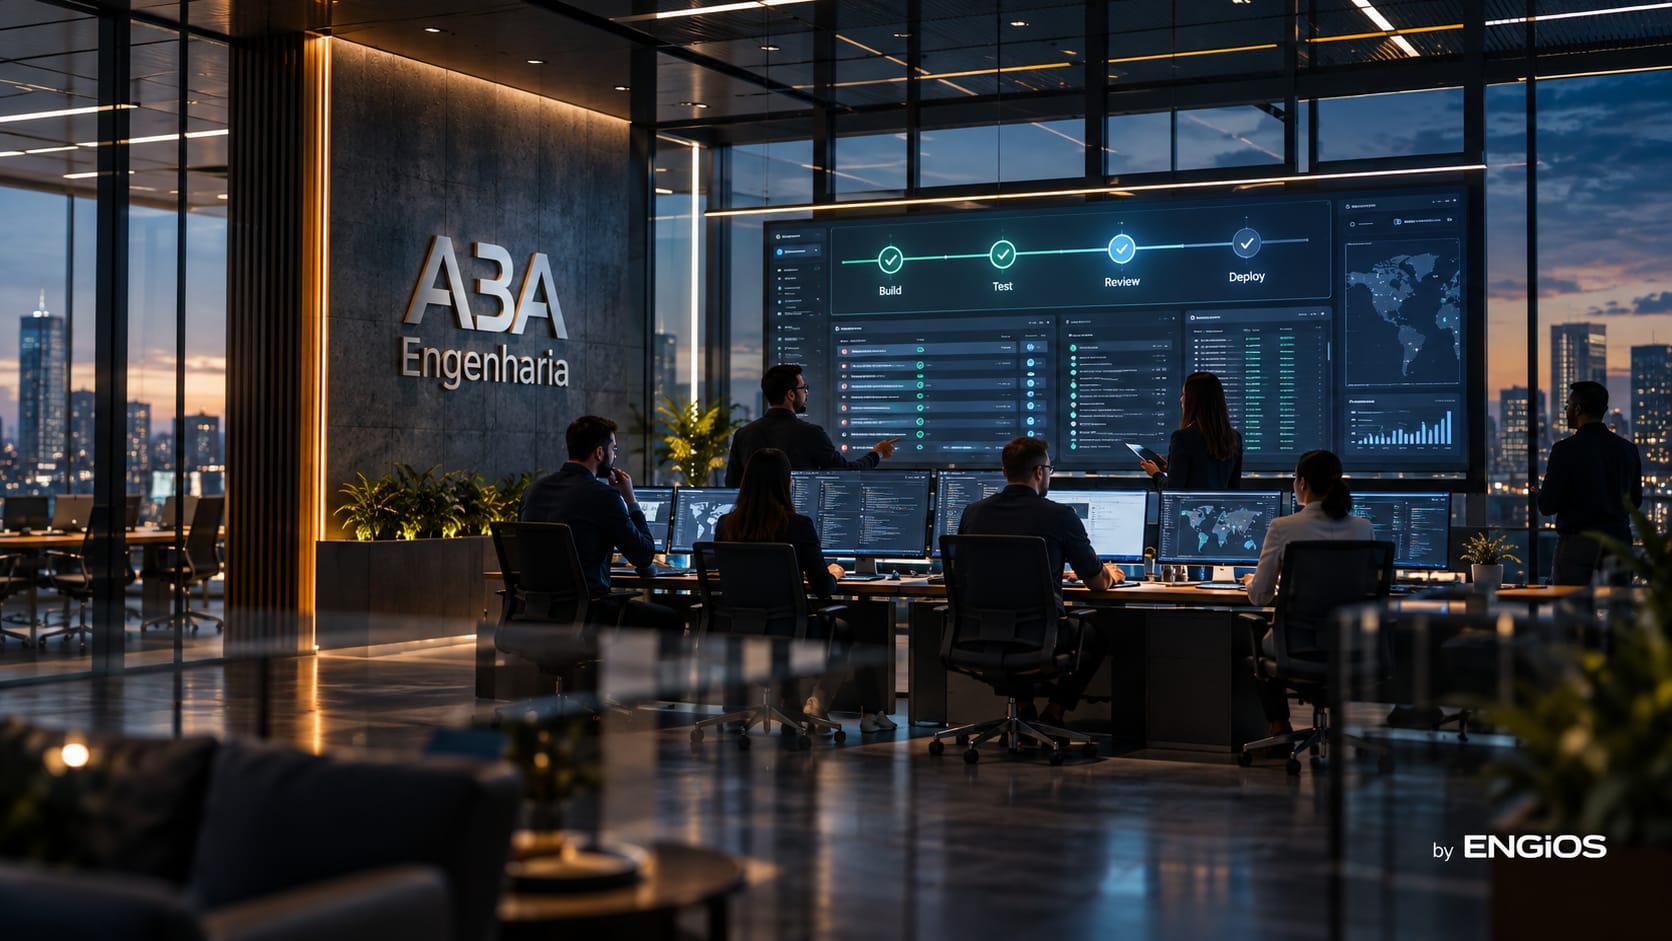
A arquitetura normalmente começa no repositório de código e termina na observação do comportamento da versão implantada. Entre esses pontos existem estágios de integração, compilação, análise, testes, geração de artefatos, publicação, promoção, implantação, validação e registro. Cada estágio deve possuir entradas, saídas e critérios claros.
Separar pipeline de build do pipeline de release costuma melhorar controle. O primeiro transforma código em artefato verificável; o segundo promove uma versão já conhecida entre ambientes. Essa separação ajuda a preservar o princípio de build once, deploy many: o mesmo artefato aprovado é movido até produção, reduzindo diferenças introduzidas por recompilações.
O pipeline também precisa ser tratado como código. Definições versionadas permitem revisão, comparação, rollback e auditoria das próprias regras de entrega. Alterar uma etapa de teste ou permissão de produção passa a ser uma mudança controlada, e não uma configuração invisível dentro da interface de uma ferramenta.
Integração contínua e qualidade do código
Build reproduzível e dependências
O build precisa produzir resultado previsível a partir de uma versão conhecida do código e de suas dependências. Versões não fixadas, downloads externos não controlados e ferramentas diferentes entre máquinas aumentam a possibilidade de gerar artefatos distintos a partir do mesmo commit.
Ambientes de build isolados, caches controlados e manifests de dependências ajudam a melhorar repetibilidade. Quando containers são utilizados, a imagem de build e a imagem da aplicação também precisam possuir versionamento e política de atualização.
Testes automatizados e quality gates
Testes unitários, integração, contratos, regressão e outras verificações podem ser incorporados conforme a natureza do sistema. O objetivo não é executar todos os testes possíveis em cada commit, mas construir uma estratégia em camadas que forneça retorno rápido sem reduzir cobertura onde o risco exige profundidade.
Quality gates transformam critérios em condições de avanço. Cobertura mínima, falhas críticas, análise estática, vulnerabilidades, testes funcionais ou aprovação manual podem bloquear a promoção. O gate precisa representar risco real; controles excessivos e lentos podem incentivar equipes a contornar o pipeline.
Análise de segurança e cadeia de suprimentos
O pipeline é parte da cadeia de suprimentos de software e, por isso, também precisa ser protegido. Análise de dependências, verificação de segredos, SAST, políticas de imagem, assinaturas e inventário de componentes podem ser incorporados conforme criticidade. O resultado dessas verificações deve permanecer associado à versão que foi produzida.
Controles de segurança precisam considerar também o próprio executor do pipeline. Um runner com privilégios excessivos ou acesso permanente a produção cria uma superfície de ataque relevante. Identidades de curta duração e segregação entre ambientes reduzem exposição.
Automatizar o deploy não é suficiente se o pipeline não consegue provar o que foi construído, testado e publicado.
A rastreabilidade precisa conectar commit, execução, resultados de teste, artefato, aprovação, ambiente e versão implantada.
Artefatos, registries e promoção entre ambientes
O artefato produzido pelo pipeline pode ser um pacote, binário, imagem de container ou outro formato distribuível. Independentemente da tecnologia, ele precisa possuir identificação inequívoca e armazenamento em repositório controlado. Versões sobrescritas dificultam auditoria e tornam rollback pouco confiável.
A promoção entre desenvolvimento, teste, homologação e produção deve modificar configuração de ambiente, e não reconstruir o software. O mesmo artefato que passou pelos testes precisa chegar à etapa seguinte. Quando uma compilação diferente é gerada em produção, perde-se parte da evidência obtida nos ambientes anteriores.
Políticas de retenção também são necessárias. Manter todos os artefatos indefinidamente pode ser inviável; remover cedo demais pode impedir recuperação de uma versão ou investigação de incidente. A estratégia deve considerar frequência de release, requisitos de auditoria e janela de rollback.
Estratégias de release e implantação
Rolling, blue-green e canary
A estratégia de implantação depende da aplicação e da infraestrutura. Rolling update substitui instâncias progressivamente; blue-green mantém dois ambientes e troca o tráfego; canary expõe uma parcela controlada dos usuários à nova versão. Nenhuma abordagem é inerentemente superior: custo, arquitetura, state, banco de dados e tolerância a indisponibilidade condicionam a escolha.
A estratégia também precisa considerar compatibilidade entre versões. Mudanças de esquema de banco, APIs e filas podem impedir rollback simples. Em muitos casos, a reversão exige que aplicações e dados sejam projetados para coexistência temporária entre versões.
Feature flags e desacoplamento entre deploy e release
Feature flags podem permitir que código seja implantado sem disponibilizar imediatamente uma funcionalidade a todos os usuários. Isso reduz o acoplamento entre publicação técnica e liberação funcional, mas introduz nova camada de configuração que precisa ser governada e posteriormente removida quando deixa de ser necessária.
Rollback e roll-forward
Rollback precisa ser uma capacidade testada, não uma instrução teórica. A equipe deve conhecer quais componentes podem voltar de versão e quais mudanças são irreversíveis. Em alguns incidentes, corrigir rapidamente e avançar com um novo release pode ser mais seguro que retornar uma configuração incompatível.
Segredos, identidades e segregação de ambientes
Credenciais não devem ser incorporadas ao repositório ou persistidas em arquivos de pipeline. Cofres de segredos, variáveis protegidas e mecanismos de identidade permitem fornecer acesso somente no momento necessário. O pipeline precisa aplicar menor privilégio e separar permissões de leitura, publicação e implantação.
Produção merece controles adicionais. Aprovações, ambientes protegidos, restrições de branch, revisão por pares e separação de responsabilidades podem ser aplicados conforme criticidade. O objetivo não é tornar cada release burocrático, mas impedir que uma única credencial ou alteração não revisada tenha capacidade irrestrita de modificar o ambiente.
Logs também precisam evitar exposição de informações sensíveis. Ferramentas de CI/CD podem registrar comandos, variáveis e respostas de APIs; mascaramento, políticas de retenção e revisão das integrações reduzem vazamentos acidentais.
Integração com containers, IaC e configuração
CI/CD torna-se mais robusto quando código de aplicação, infraestrutura e configuração possuem ciclos de mudança compatíveis. Containerização de Aplicações melhora portabilidade do runtime; Infraestrutura como Código permite versionar recursos; e a Automação de Infraestrutura reduz configuração manual e drift.
Essas práticas não eliminam a necessidade de separar responsabilidades. Mudanças de aplicação e infraestrutura podem possuir ritmos, riscos e aprovadores distintos. O pipeline deve representar essas diferenças em vez de forçar tudo a uma única sequência.
Ambientes efêmeros podem ser criados para testes de branches ou pull requests quando a arquitetura permitir. Isso aumenta fidelidade da validação, mas exige controle de custo, limpeza automática e dados de teste adequados.
Observabilidade do pipeline e da versão implantada
O sucesso técnico do job de deploy não prova que a aplicação está saudável. Após a implantação, métricas, logs, traces, health checks e testes sintéticos podem indicar se a nova versão alterou latência, erros, consumo de recursos ou comportamento funcional. A integração entre pipeline e observabilidade reduz o tempo entre falha e diagnóstico.
O próprio pipeline também precisa ser observado. Taxa de falha, duração, filas, flakiness de testes e frequência de rollback revelam gargalos. Um pipeline constantemente ignorado ou reexecutado até “passar” perde sua função de controle.
Métricas de fluxo como frequência de deploy, tempo de mudança, taxa de falha e tempo de recuperação podem apoiar melhoria contínua, desde que interpretadas em contexto. Transformá-las em metas isoladas pode estimular comportamento inadequado.
Ciclo de vida da solução
A implantação começa pelo mapeamento do processo atual: repositórios, branches, builds, testes, ambientes, aprovações, artefatos, credenciais e método de deploy. O diagnóstico identifica tarefas manuais, dependências individuais, falhas recorrentes e diferenças entre ambientes.
Em seguida é desenhada a arquitetura alvo e normalmente selecionado um pipeline-piloto. A implementação progressiva permite validar runners, permissões, tempos de execução, testes e integrações antes de padronizar múltiplos projetos.
Após estabilização, templates, componentes reutilizáveis e políticas podem reduzir duplicação. Padronização não significa tornar todos os projetos idênticos: o núcleo comum deve conviver com extensões específicas de tecnologia e risco.
Verificação, homologação e critérios de aceite
O pipeline deve ser testado como qualquer solução de engenharia. É necessário verificar caminhos de sucesso e falha: build quebrado, teste reprovado, vulnerabilidade crítica, indisponibilidade do registry, segredo ausente, aprovação negada, timeout, falha parcial de deploy e rollback.
Critérios de aceite podem incluir reprodução do build, promoção do mesmo artefato, proteção de ambientes, rastreabilidade de aprovações, logs suficientes, rollback funcional e documentação de operação. Também é importante validar que a equipe consegue manter o pipeline sem depender exclusivamente de quem o implantou.
A documentação pode incluir arquitetura, templates, fluxos de branches e releases, matriz de permissões, gestão de segredos, registries, procedimentos de contingência, troubleshooting e critérios para inclusão de novos projetos.
Mudanças de banco de dados, estado e compatibilidade
Nem toda implantação pode ser revertida apenas republicando uma versão anterior. Alterações de schema, migrações de dados, filas, contratos de API e formatos persistidos podem criar dependências entre versões. Por isso, estratégia de CI/CD precisa considerar componentes com estado e definir como mudanças serão aplicadas, verificadas e recuperadas.
Migrações de banco devem ser compatíveis com a estratégia de release. Em ambientes com rolling ou canary, versões antiga e nova podem operar simultaneamente durante um período. Alterações destrutivas aplicadas cedo demais podem impedir coexistência e transformar rollback em uma operação de recuperação de dados.
Práticas como expansão e contração de schema, migrações versionadas e validação prévia reduzem esse risco. O pipeline pode verificar se scripts foram aplicados, registrar a versão de banco associada à release e impedir promoção quando pré-condições não são atendidas.
Governança de runners, execução e capacidade
Runners e agentes de execução são infraestrutura crítica do pipeline. Eles processam código potencialmente não confiável, acessam registries e, em alguns desenhos, recebem credenciais para ambientes. Isolamento entre jobs, atualização das imagens de execução, limpeza de workspace e segmentação por nível de confiança ajudam a reduzir propagação de risco.
A capacidade também precisa ser dimensionada. Filas longas de build reduzem velocidade de feedback e incentivam commits maiores, o que aumenta dificuldade de diagnóstico. Escalonamento, paralelização e cache podem melhorar desempenho, mas devem ser equilibrados com custo e previsibilidade.
Dependências externas merecem tratamento de contingência. Indisponibilidade de registry, serviço de análise ou provedor cloud não deve produzir releases parcialmente executadas sem estado conhecido. Timeouts, retries, idempotência e critérios de falha precisam ser desenhados conforme o estágio e o efeito de uma execução incompleta.
Considerações de Engenharia
Pipeline rápido não compensa teste irrelevante
O objetivo não é apenas reduzir minutos de execução. Um pipeline eficiente produz feedback útil no momento adequado e mantém controles proporcionais ao risco.
Mais gates podem reduzir segurança se incentivarem atalhos
Controles sem relação clara com risco tendem a ser contornados. Gates precisam ser objetivos, automatizados quando possível e possuir exceções formalmente governadas.
Recompilar em produção rompe parte da evidência de homologação
Promover o mesmo artefato preserva a relação entre aquilo que foi testado e aquilo que foi publicado. Builds independentes podem introduzir diferenças difíceis de perceber.
Automação não elimina responsabilidade operacional
Alguém continua responsável por definir critérios, aprovar risco, responder a falhas e manter integrações. O pipeline torna essas responsabilidades mais explícitas; não as remove.
Plataformas, aplicações e soluções relacionadas
A implementação pode utilizar GitHub Actions, GitLab CI/CD, Jenkins, Azure DevOps Pipelines ou outras plataformas, conforme ecossistema, hospedagem, integrações, requisitos de segurança e competências da equipe. A escolha da ferramenta é secundária diante da arquitetura do processo.
CI/CD se conecta diretamente à Containerização de Aplicações, à Infraestrutura como Código, à Automação de Infraestrutura e à Observabilidade de Sistemas e Aplicações. Em programas de transformação, também pode integrar iniciativas de Migração e Modernização para Nuvem.
CI/CD bem estruturado reduz variabilidade sem retirar os controles necessários para produção.
O objetivo é tornar cada release repetível, rastreável e recuperável, com critérios de qualidade incorporados ao fluxo em vez de depender de conferências informais.
Modelo de contratação
A implantação pode começar por um assessment do processo atual e um pipeline-piloto, avançar para padronização de múltiplos repositórios ou integrar um programa mais amplo de modernização DevOps. O escopo depende da quantidade de aplicações, tecnologias, ambientes e controles existentes.
Os entregáveis podem incluir arquitetura de CI/CD, pipelines versionados, templates reutilizáveis, integração com testes e registries, gestão de segredos, estratégia de release, documentação, homologação e transferência de conhecimento. Quando necessário, o trabalho também pode incluir desenho de integração com infraestrutura como código e observabilidade.
O resultado esperado é reduzir a distância entre alteração de código e publicação controlada, mantendo evidência suficiente para compreender o que mudou, por que passou pelos gates e como recuperar o ambiente em caso de falha.
Seu processo de build ou deploy ainda depende de execução manual, conhecimento individual ou validações inconsistentes?
A A3A Engenharia pode avaliar o fluxo atual e estruturar uma arquitetura de CI/CD compatível com as tecnologias, controles e requisitos de operação do ambiente.