 Conhecimento em engenharia
A3A Academy
 Análise de risco
TONITRU Risk Assessment
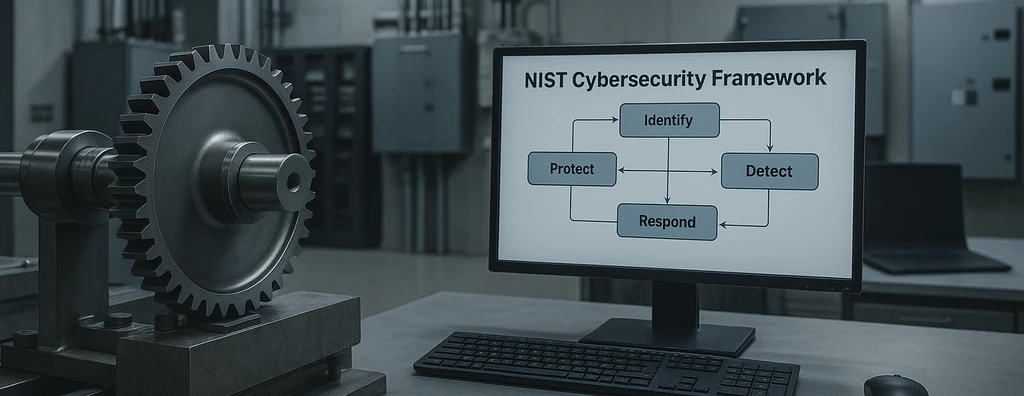
Entenda o NIST CSF 2.0, suas seis funções, Profiles, Tiers, cadeia de suprimentos, evidências e como aplicar o framework na gestão de riscos.
Confira!
O NIST Cybersecurity Framework (CSF) é uma estrutura para organizar, priorizar e comunicar a gestão de riscos de cibersegurança. Ele foi desenvolvido pelo National Institute of Standards and Technology dos Estados Unidos e, na versão 2.0, passou a ser apresentado explicitamente como referência aplicável a organizações de qualquer porte, setor ou nível de maturidade.
O framework não define uma arquitetura técnica única nem prescreve produtos, fabricantes ou controles específicos. Seu papel é organizar resultados desejados de cibersegurança em uma linguagem comum, permitindo que liderança, equipes técnicas, risco, jurídico, fornecedores e operação discutam prioridades de forma coerente.
A versão 2.0, publicada em 2024, ampliou o foco de governança, cadeia de suprimentos e gestão de risco empresarial. O Core passou a incluir seis funções: Govern, Identify, Protect, Detect, Respond e Recover. O valor do CSF está em transformar essas funções em perfis, prioridades, gaps e planos de melhoria adequados ao contexto de cada organização.
O que é o NIST Cybersecurity Framework 2.0
O NIST CSF 2.0 é uma taxonomia de resultados de alto nível para gestão de riscos de cibersegurança. Esses resultados são organizados em Functions, Categories e Subcategories. A estrutura permite avaliar o que a organização precisa alcançar sem determinar exatamente qual tecnologia deve ser utilizada.
Essa característica torna o framework flexível. Uma empresa industrial, um órgão público, um Data Center ou uma organização de serviços podem utilizar o mesmo Core, mas implementar resultados por arquiteturas e controles diferentes.
O CSF não substitui normas como ISO/IEC 27001, controles do CIS, políticas corporativas ou requisitos regulatórios. Ele pode funcionar como camada de organização que conecta objetivos de risco a diferentes referências técnicas e de governança.
Também não é um checklist de conformidade binária. A organização pode usar o CSF para estabelecer estado atual, estado-alvo e prioridades. O foco é melhorar capacidade de gestão e resiliência, não simplesmente marcar itens como “atendidos”.
Core, Functions, Categories e Subcategories
Uma vantagem dessa hierarquia é permitir granularidade sem perder visão executiva. A liderança pode acompanhar Functions e Categories, enquanto equipes técnicas trabalham nas Subcategories e nas evidências necessárias para demonstrar atendimento. Essa decomposição evita que a conversa de risco fique presa em detalhes de produto e facilita consolidar diferentes disciplinas dentro do mesmo modelo.
Também é importante manter identificadores do Core nas matrizes internas. Ao relacionar requisito, controle, evidência e responsável a uma Subcategory específica, a organização reduz ambiguidades e consegue atualizar o mapeamento quando processos ou tecnologias mudam. O CSF deixa de ser apenas referência documental e passa a funcionar como estrutura de rastreabilidade.
O Core é a parte central do CSF. Ele organiza resultados de cibersegurança em uma hierarquia comum. No nível mais alto estão as seis Functions: Govern, Identify, Protect, Detect, Respond e Recover.
Cada Function contém Categories que agrupam resultados relacionados. As Categories, por sua vez, são detalhadas em Subcategories. Uma Subcategory descreve um resultado esperado, mas normalmente não explica exatamente como implementá-lo.
Essa separação é importante porque permite adaptar controles ao contexto. Duas organizações podem buscar o mesmo resultado de proteção de identidade usando arquiteturas diferentes, desde que consigam demonstrar que o risco está sendo tratado.
O framework também utiliza Implementation Examples e Informative References como apoio. Esses recursos ajudam a relacionar resultados do CSF a práticas e referências externas, mas não transformam o CSF em catálogo de controles.
Para gestão, essa estrutura cria uma linguagem de rastreabilidade. Um risco identificado pode ser associado a Subcategories, iniciativas, responsáveis, métricas e evidências. Isso facilita revisão executiva e auditoria técnica.
Govern: governança e direção de risco
Governança também precisa definir critérios de aceitação de risco. Nem toda vulnerabilidade será eliminada imediatamente, e nem todo controle terá custo justificável. A decisão de aceitar, mitigar, transferir ou evitar um risco deve ter autoridade definida, prazo de revisão e justificativa registrada. Sem esse mecanismo, exceções técnicas podem permanecer indefinidamente sem owner.
Outro ponto é a integração com orçamento e portfólio. O Target Profile pode indicar dezenas de gaps, mas recursos são finitos. A governança deve priorizar iniciativas conforme criticidade, exposição, dependências e benefício esperado. Isso evita projetos de segurança desconectados da estratégia e permite demonstrar por que determinada ação recebeu prioridade sobre outra.
Govern foi incorporada como função explícita no CSF 2.0. Ela posiciona a cibersegurança como componente do risco empresarial, e não apenas como responsabilidade operacional da equipe de TI.
Govern envolve contexto organizacional, estratégia de gestão de risco, papéis, responsabilidades, políticas, supervisão e cadeia de suprimentos. A liderança precisa definir tolerância a risco, prioridades e mecanismos de decisão que orientem as demais funções.
Papéis precisam ser claros. Quem aprova exceções? Quem aceita risco residual? Quem responde por ativos terceirizados? Quem acompanha indicadores? Sem governança, controles podem existir de forma isolada sem relação com objetivos de negócio.
Políticas também precisam refletir capacidade real. Uma política que exige patching em prazo incompatível com operação industrial, por exemplo, cria não conformidade permanente. O CSF ajuda a alinhar expectativa, risco e implementação.
Cadeia de suprimentos ganhou destaque porque dependências externas podem introduzir riscos técnicos e operacionais. Fornecedores de software, cloud, manutenção, telecomunicações e sistemas OT precisam ser tratados dentro da governança.
Identify: ativos, contexto e risco
Identify organiza resultados relacionados ao entendimento do ambiente e dos riscos existentes. Sem inventário confiável, a organização não sabe exatamente o que precisa proteger.
O inventário deve incluir hardware, software, serviços, dados, identidades e dependências externas. Em ambientes convergentes, também deve abranger sistemas OT, automação, CFTV, controle de acesso, BMS e outros dispositivos conectados.
Classificação de criticidade é essencial. Dois switches podem parecer tecnicamente semelhantes, mas um pode atender área administrativa e outro um sistema de missão crítica. O impacto de indisponibilidade ou comprometimento precisa orientar prioridade.
Mapeamento de dependências ajuda a identificar efeitos em cascata. Um servidor pode depender de DNS, autenticação, storage, rede e energia. Proteger apenas o ativo final sem compreender suas dependências cria falsa sensação de resiliência.
Avaliação de risco combina ameaça, vulnerabilidade, impacto e contexto. O CSF não impõe um único método quantitativo ou qualitativo, mas espera que decisões sejam baseadas em risco e revisadas ao longo do tempo.
Protect: controles e redução de exposição
Protect também precisa considerar configuração segura ao longo do ciclo de vida. Baselines, hardening, revisão de exceções e gestão de mudanças evitam que controles se deteriorem com o tempo. Um servidor pode ter sido implantado de forma segura e se tornar exposto meses depois por abertura de porta, conta temporária não removida ou pacote desatualizado.
O princípio de menor privilégio deve ser aplicado a pessoas, aplicações e serviços. Contas técnicas com acesso excessivo criam caminhos de comprometimento difíceis de detectar. Revisões periódicas de permissões, segregação de funções e uso de credenciais específicas por serviço reduzem o impacto potencial de uma conta comprometida.
Protect reúne resultados destinados a reduzir probabilidade ou impacto de eventos adversos. Isso inclui identidade, acesso, proteção de dados, segurança de plataformas, manutenção e resiliência tecnológica.
Gestão de identidade deve aplicar menor privilégio, autenticação adequada e revisão periódica de acessos. Contas administrativas merecem tratamento específico, com segregação e rastreabilidade.
Proteção de dados envolve criptografia, backups, retenção, classificação e controle de transferência. A organização precisa saber quais dados são críticos, onde estão armazenados e quem pode acessá-los.
Segurança de plataformas inclui hardening, patching, configuração segura, proteção de endpoints e gestão de vulnerabilidades. Esses controles devem ser priorizados conforme exposição e criticidade, não aplicados de forma cega.
Rede também faz parte de Protect. Segmentação, firewalls, controle de tráfego, NAC e arquitetura Zero Trust podem reduzir movimento lateral. Entretanto, o desenho precisa considerar disponibilidade, operação e dependências reais.
Detect: visibilidade e identificação de eventos
A cobertura de detecção deve ser comparada com a superfície real de ataque. É comum possuir boa visibilidade de endpoints corporativos e pouca telemetria em appliances, switches, sistemas legados ou serviços terceirizados. Mapear lacunas de logging ajuda a priorizar integração de fontes e reduz áreas onde um atacante pode atuar sem gerar evidência suficiente.
Casos de uso de detecção precisam ser testados. Gerar um alerta em ferramenta não garante que o SOC receba, interprete e escale corretamente. Simulações, purple team e exercícios controlados podem validar a cadeia desde o evento técnico até a resposta humana, identificando falhas de regra, integração, prioridade ou processo.
Detect trata da capacidade de perceber atividades anormais ou potencialmente maliciosas. Sem visibilidade, a organização pode possuir controles preventivos e ainda permanecer longos períodos sem perceber um comprometimento.
Logs de sistemas, autenticação, firewalls, endpoints, aplicações e serviços cloud precisam ser coletados de acordo com o risco. A centralização facilita correlação e investigação, mas exige retenção, normalização e proteção.
SIEM e outras plataformas podem ajudar, porém tecnologia sem casos de uso definidos produz grande volume de alertas com baixo valor. O projeto deve relacionar fontes de log a ameaças e hipóteses de detecção.
Detecção também envolve baseline. Para reconhecer comportamento anômalo, é necessário conhecer padrões normais de tráfego, autenticação, uso de recursos e alterações administrativas.
Em ambientes OT ou de segurança eletrônica, visibilidade precisa considerar protocolos, ativos legados e impacto de ferramentas de inspeção. Nem todo método utilizado em TI pode ser aplicado sem avaliação.
Respond: resposta e contenção
Respond organiza capacidade de agir quando um incidente é detectado. A resposta precisa ser planejada antes do evento, porque decisões tomadas sob pressão tendem a ser mais lentas e inconsistentes.
Planos devem definir papéis, escalonamento, comunicação, análise, contenção e coordenação com partes externas. Um incidente pode envolver TI, jurídico, proteção de dados, comunicação corporativa, fornecedores e liderança.
Playbooks ajudam a padronizar resposta para cenários recorrentes como ransomware, conta comprometida, vazamento, malware ou indisponibilidade. Eles devem ser suficientemente detalhados para orientar ação sem impedir julgamento técnico.
Contenção precisa equilibrar segurança e continuidade. Desligar um sistema pode eliminar uma ameaça, mas também interromper processo crítico. Em ambientes industriais e de missão crítica, decisões devem considerar segurança física e operacional.
Lições aprendidas precisam retornar ao ciclo. Se um incidente revelou falha de inventário, autenticação ou monitoramento, o tratamento não termina quando o serviço é restaurado.
Recover: recuperação e resiliência
Planos de recuperação também precisam considerar perda de confiança no ambiente. Após comprometimento relevante, simplesmente restaurar servidores pode reintroduzir persistência maliciosa. Em alguns cenários, a estratégia deve prever reconstrução a partir de imagens conhecidas, rotação de credenciais, validação de integridade e revisão de configurações antes da reconexão ao ambiente produtivo.
Exercícios de recuperação ajudam a validar dependências organizacionais além da tecnologia. Aprovação de mudança, disponibilidade de fornecedores, acesso físico, documentação e comunicação podem atrasar o retorno mesmo quando backups estão íntegros. O CSF permite tratar essas dependências como parte do resultado de resiliência e não como problemas separados.
Recover trata da capacidade de restaurar serviços e reduzir efeitos residuais após incidentes. Backup é parte importante, mas recuperação envolve muito mais do que possuir cópias de dados.
RPO e RTO precisam estar alinhados à criticidade. Sistemas diferentes podem exigir estratégias distintas de replicação, backup, site alternativo e priorização.
Backups devem ser testados. Uma cópia não validada pode estar corrompida, incompleta ou inacessível durante o incidente. Exercícios de restauração fornecem evidência real de capacidade.
Recuperação também exige infraestrutura. DNS, autenticação, rede, storage, servidores e energia podem ser pré-requisitos para restaurar aplicações. Mapear essa sequência reduz tempo de indisponibilidade.
A comunicação pós-incidente também pertence à recuperação. Stakeholders precisam saber quando serviços foram restabelecidos, quais limitações permanecem e quais ações serão tomadas.
Profiles: estado atual e estado-alvo
O Current Profile deve ser baseado em evidências, não em declarações genéricas. Uma política publicada pode indicar intenção, mas não prova que o processo funciona. Inventários, amostras de configuração, logs, registros de teste e indicadores ajudam a distinguir controle formal de capacidade efetivamente implementada.
Já o Target Profile precisa ser realista e priorizado. Copiar integralmente um perfil de outra organização pode gerar objetivos incompatíveis com risco, tecnologia ou orçamento. O target deve refletir contexto próprio, incluindo requisitos regulatórios, contratos, criticidade dos serviços e capacidade de operação. Essa adaptação é parte central do uso correto do CSF.
Organizational Profiles são um dos mecanismos mais práticos do CSF. Um Current Profile registra resultados que a organização alcança atualmente; um Target Profile descreve resultados desejados de acordo com contexto, riscos e prioridades.
A diferença entre os dois perfis cria uma visão estruturada de gaps. Esses gaps podem ser transformados em iniciativas, responsáveis, orçamento e cronograma.
Perfis não precisam tratar todas as Subcategories com a mesma prioridade. A organização pode selecionar resultados relevantes e definir prioridades conforme criticidade e risco.
Community Profiles podem oferecer referência para setores ou comunidades com necessidades semelhantes. Eles ajudam a acelerar elaboração, mas não eliminam a necessidade de adaptação.
Um perfil bem construído também melhora comunicação executiva. Em vez de discutir centenas de controles isolados, a liderança visualiza resultados de risco, gaps e evolução.
Tiers e maturidade relativa
Os CSF Tiers descrevem características da forma como a organização gerencia riscos de cibersegurança. Eles variam de abordagens mais ad hoc a práticas adaptativas e integradas.
Tiers não devem ser usados como ranking universal de “bom” ou “ruim”. O nível adequado depende de risco, recursos e contexto. Nem toda organização precisa maximizar todos os aspectos.
Também é importante não confundir Tiers com modelo de maturidade formal. Eles fornecem contexto sobre práticas de gestão, mas o CSF não foi concebido como certificação de maturidade.
A utilidade está em identificar consistência, integração e capacidade de adaptação. Uma organização pode possuir tecnologia avançada e ainda operar de maneira reativa por falta de governança.
CSF e outras referências
Mapeamentos devem ser usados com critério. Duas referências podem tratar o mesmo tema em níveis de detalhe diferentes, e uma correspondência entre Subcategory e controle não significa equivalência perfeita. A equipe precisa entender objetivo, escopo e evidência exigida por cada documento antes de considerar um requisito atendido. Mapear mecanicamente identificadores pode produzir cobertura aparente sem reduzir o risco.
Em ambientes regulados, o CSF pode funcionar como camada de consolidação para requisitos provenientes de várias fontes. A matriz pode relacionar obrigação legal, requisito contratual, controle técnico, owner e evidência. Isso simplifica governança e evita manter programas paralelos para cada referência. O cuidado é preservar a exigência original: o framework organiza, mas não reduz obrigações mais específicas.
O NIST CSF foi projetado para coexistir com outras referências. ISO/IEC 27001 pode fornecer requisitos de sistema de gestão; CIS Controls oferece controles priorizados; NIST SP 800-53 apresenta catálogo detalhado; IEC 62443 trata ambientes industriais; outras normas atendem contextos específicos.
Informative References conectam Subcategories do CSF a documentos externos. Esse mapeamento permite reutilizar controles existentes e evitar duplicação desnecessária.
A organização deve evitar “framework stacking” sem propósito. Adotar várias referências simultaneamente sem arquitetura de governança pode criar sobreposição e dificuldade de evidência.
Uma abordagem melhor é definir uma estrutura principal de gestão e mapear obrigações regulatórias e controles técnicos a ela. O CSF pode exercer esse papel de organização, desde que as equipes entendam suas limitações.
Como implementar o NIST CSF
Uma implantação prática pode começar por escopo limitado, como um processo crítico, unidade ou plataforma, antes de expandir para toda a organização. Essa abordagem permite validar metodologia de entrevistas, evidências, scoring e priorização sem criar um programa excessivamente grande logo no início. O aprendizado do primeiro ciclo pode ser incorporado aos demais domínios.
O roadmap deve explicitar dependências entre iniciativas. Implantar SIEM antes de organizar fontes de log e inventário pode produzir baixa qualidade; exigir MFA antes de corrigir identidades duplicadas pode aumentar exceções. Sequenciar ações de acordo com pré-requisitos técnicos reduz retrabalho e melhora a chance de cada investimento produzir o resultado esperado.
Transformar o CSF em roadmap exige priorizar riscos, definir responsáveis, estimar dependências e estabelecer evidências de conclusão. O framework organiza resultados; a gestão de riscos transforma esses resultados em decisões, tratamento e contingência.
A implementação começa pelo contexto organizacional. É necessário entender missão, ativos críticos, dependências, obrigações, ameaças e tolerância a risco.
Em seguida, a organização pode construir um Current Profile. Isso exige entrevistas, análise documental, inventário, evidências de controles e observação da operação. O objetivo não é apenas registrar políticas existentes, mas verificar resultados efetivamente alcançados.
Depois é criado o Target Profile, priorizando resultados que reduzem riscos relevantes. O gap entre Current e Target deve gerar um roadmap.
O roadmap precisa conter responsáveis, dependências, prazo, custo, risco tratado e evidência de conclusão. Iniciativas genéricas como “melhorar monitoramento” não são suficientes. É necessário especificar quais fontes, casos de uso e métricas serão implantados.
A implementação deve ocorrer por ciclos. Mudanças tecnológicas, novas ameaças, aquisições e incidentes alteram o risco. O perfil precisa ser revisado periodicamente.
Evidências, métricas e governança operacional
Evidências precisam ter validade temporal. Um relatório de vulnerabilidade de seis meses atrás pode não representar o ambiente atual; uma lista de ativos pode estar desatualizada após mudanças. A organização deve definir periodicidade e fonte de verdade para cada evidência, evitando avaliações baseadas em documentos estáticos que já não correspondem à operação.
Indicadores também devem ter owner e regra de cálculo. “Cobertura de patching” pode significar ativos com agente instalado, ativos efetivamente atualizados ou ativos dentro do SLA; cada interpretação produz resultado diferente. Definições claras permitem comparar períodos e evitar que métricas sejam ajustadas apenas para melhorar aparência executiva.
O CSF ganha valor quando resultados podem ser demonstrados. Evidências incluem inventários, configurações, logs, relatórios, políticas, registros de testes e indicadores.
Métricas devem relacionar capacidade a risco. Percentual de ativos inventariados, cobertura de MFA, tempo de correção, cobertura de backup, tempo de detecção e restauração podem ser úteis quando corretamente definidos.
Evite métricas de vaidade. Quantidade de alertas ou número de ferramentas não demonstra necessariamente melhor segurança. O indicador deve ajudar a responder se a organização consegue alcançar o resultado esperado.
Responsáveis precisam estar definidos por outcome. Algumas Subcategories pertencem a segurança, outras dependem de infraestrutura, RH, jurídico, procurement ou operação.
Revisões periódicas devem comparar evidências ao Target Profile e registrar riscos residuais. Essa disciplina transforma o CSF em mecanismo de governança contínua.
Cadeia de suprimentos e terceiros
A criticidade do fornecedor deve considerar substituibilidade. Um prestador facilmente substituível apresenta perfil diferente de uma plataforma proprietária profundamente integrada à operação. Dependência tecnológica, posse dos dados, disponibilidade de documentação e tempo necessário para transição influenciam o risco tanto quanto controles de segurança tradicionais.
Durante contratação, evidências podem incluir práticas de desenvolvimento seguro, gestão de vulnerabilidades, certificações, testes, política de incidentes e arquitetura de acesso remoto. Porém, questionários extensos sem validação geram falsa confiança. Para fornecedores críticos, respostas precisam ser confrontadas com documentação, contratos, demonstrações técnicas ou auditorias proporcionais ao risco.
Fornecedores podem introduzir software, acesso remoto, dependências e dados no ambiente. O CSF 2.0 reforça Cybersecurity Supply Chain Risk Management dentro da governança.
Requisitos de segurança precisam entrar em contratação antes da assinatura. Exigir controles somente depois reduz poder de negociação e pode criar incompatibilidade com produtos já adquiridos.
Avaliação de fornecedor deve considerar criticidade do serviço, acesso a dados, conectividade, dependências e capacidade de resposta. Nem todos os fornecedores precisam da mesma profundidade de due diligence.
Contratos podem incluir requisitos de notificação de incidentes, patching, acesso remoto, logs, continuidade, subcontratação e encerramento.
No offboarding, credenciais, conexões, certificados e dados precisam ser removidos ou transferidos de forma controlada.
Infraestrutura, redes e sistemas críticos
Em redes, a tradução do CSF deve ser rastreável a decisões concretas: quais segmentos existem, quais fluxos são permitidos, como acessos administrativos são protegidos, quais eventos são registrados e como a arquitetura reage a falhas. Essa materialização facilita auditoria e reduz a distância entre políticas de cibersegurança e configuração efetiva da infraestrutura.
Sistemas críticos também exigem análise de impacto das próprias medidas de segurança. Bloquear comunicação, aplicar patch ou reiniciar equipamento pode afetar disponibilidade ou segurança operacional. A gestão de risco deve definir quando controles podem ser aplicados diretamente, quando precisam de janela e testes e quando medidas compensatórias são necessárias.
Outcomes de Protect e Detect precisam aparecer na arquitetura real: segmentação, autenticação, logging, redundância, proteção de administração e fluxos permitidos. Projetar a rede com esses requisitos desde o início reduz dependência de controles adicionados apenas depois da implantação.
Resultados do CSF precisam ser traduzidos para arquitetura técnica. Em redes corporativas, isso pode envolver segmentação, autenticação, logging, redundância e proteção de administração.
Em Data Centers, segurança precisa coexistir com disponibilidade. Controles não podem criar pontos únicos de falha sem justificativa. Mudanças de firewall, autenticação ou patching devem seguir gestão de risco e testes.
Em OT, automação e segurança eletrônica, dispositivos podem ter ciclo de vida longo, protocolos proprietários e limitações de patching. O CSF permite manter o resultado de risco como objetivo e adaptar controles ao contexto.
Essa flexibilidade é uma das principais vantagens do framework. Ele não exige que todo ativo seja tratado da mesma forma; exige que a organização compreenda e gerencie o risco.
Design Review e validação técnica
O Design Review pode usar o CSF como referência de requisitos e rastreabilidade, verificando se arquitetura, controles e critérios de teste realmente suportam os resultados priorizados pela organização antes da implantação.
Projetos de infraestrutura e sistemas podem usar o CSF como uma das referências de requisitos. Durante Design Review, resultados relacionados a identidade, segmentação, logging, backup, recuperação e terceiros podem ser confrontados com a arquitetura proposta.
O objetivo não é certificar “conformidade com NIST” de forma superficial, mas verificar se decisões de projeto ajudam a alcançar os outcomes priorizados.
Matrizes de rastreabilidade podem ligar requisitos do projeto a Subcategories relevantes, controles implementados e evidências de teste.
Esse método é particularmente útil em sistemas multidisciplinares, nos quais segurança depende de rede, servidores, software, automação e operação.
Ciclo de melhoria contínua
É útil formalizar um calendário de revisão associado a eventos de gatilho. Incidentes relevantes, entrada de novo fornecedor crítico, mudança regulatória, aquisição de empresa, implantação de cloud ou alteração de arquitetura podem justificar revisão antecipada do Profile. Isso evita que a organização espere o ciclo anual enquanto o risco já mudou materialmente.
Ao final de cada ciclo, decisões precisam resultar em responsáveis, prazo e evidência. Gaps sem owner tendem a permanecer indefinidamente em relatórios. O valor do framework aparece quando a avaliação produz mudanças verificáveis e quando a liderança consegue acompanhar risco residual, ações concluídas e capacidade efetivamente obtida.
O CSF não termina com a publicação de um perfil. O ambiente muda continuamente: novos ativos, serviços cloud, fornecedores, ameaças e requisitos regulatórios alteram prioridades.
Incidentes devem alimentar o processo. Falhas observadas durante resposta e recuperação revelam gaps que podem ser incorporados ao roadmap.
Mudanças arquiteturais também exigem revisão. Uma nova integração, aquisição ou expansão pode modificar exposição e dependências.
A organização deve estabelecer periodicidade para revisar perfis, riscos, métricas e prioridades. O CSF funciona melhor como ciclo de governança do que como projeto pontual.
Ao longo do tempo, o objetivo é aumentar previsibilidade, capacidade de decisão e resiliência, usando o framework como linguagem comum entre risco, gestão e engenharia.
Referências técnicas
[1] NIST. The NIST Cybersecurity Framework (CSF) 2.0 — CSWP 29. Disponível em: https://csrc.nist.gov/pubs/cswp/29/the-nist-cybersecurity-framework-csf-20/final.
[2] NIST. Cybersecurity Framework 2.0: Resource and Overview Guide — SP 1299. Disponível em: https://csrc.nist.gov/pubs/sp/1299/final.
[3] NIST. CSF 2.0 Quick-Start Guides. Disponível em: https://www.nist.gov/cyberframework/quick-start-guides.
Perguntas frequentes
Não. O CSF é uma estrutura de gestão de riscos e resultados de cibersegurança, não um esquema de certificação.
Govern, Identify, Protect, Detect, Respond e Recover.
A versão 2.0 ampliou o escopo para todas as organizações, adicionou Govern como função explícita e reforçou governança e risco de cadeia de suprimentos.
Não. Ele pode organizar resultados e mapear outras referências, que continuam fornecendo requisitos ou controles mais específicos.
Current Profile registra outcomes alcançados atualmente; Target Profile descreve outcomes desejados. A diferença orienta o roadmap de melhoria.
Eles ajudam a caracterizar práticas de gestão de risco, mas não devem ser tratados como certificação ou ranking universal de maturidade.