 Conhecimento em engenharia
A3A Academy
 Análise de risco
TONITRU Risk Assessment
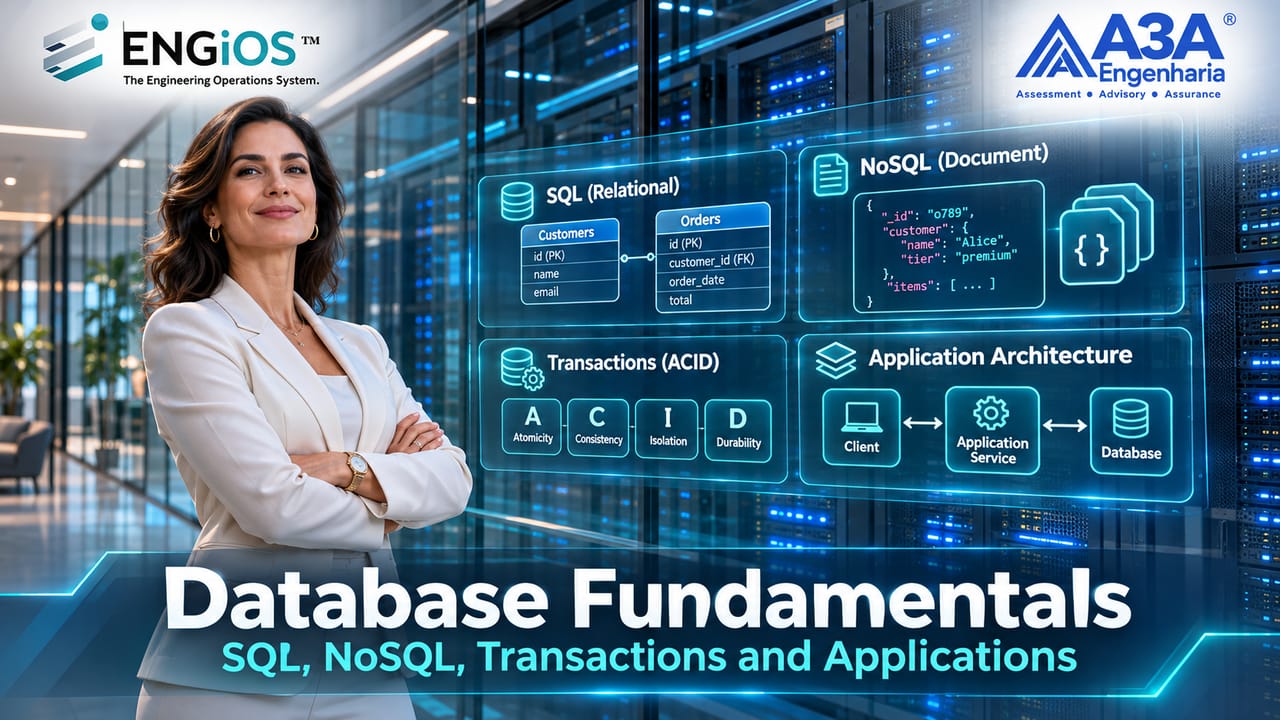
Banco de dados: conceitos, SGBD, SQL e NoSQL, modelos, ACID, segurança, desempenho e critérios técnicos para sistemas corporativos.
Confira!
Banco de dados é uma estrutura organizada de informações que permite armazenar, consultar e modificar registros segundo regras de integridade e segurança. Um SGBD, como PostgreSQL ou outros sistemas relacionais e não relacionais, gerencia concorrência, transações, acesso e recuperação. O projeto correto começa pelo modelo de dados e pelos requisitos de uso, não pelo nome do software.
O que é banco de dados e o que faz um SGBD?
Banco de dados é um conjunto organizado de informações mantidas segundo estruturas e regras que permitem consulta, atualização, integridade e controle de acesso. O Sistema de Gerenciamento de Banco de Dados (SGBD) oferece mecanismos para armazenar, consultar e alterar informações, coordenar usuários simultâneos, controlar transações e executar procedimentos de recuperação. Banco de dados não é sinônimo de planilha, servidor ou arquivo: ele pertence a uma arquitetura de informação e precisa de modelos, responsabilidades e requisitos operacionais.
Uma organização pode registrar colaboradores, equipamentos, contratos, eventos e medições em diferentes bases. Esses dados somente geram valor se os identificadores, relacionamentos, regras de qualidade e permissões estiverem definidos. Uma base contendo milhões de registros inconsistentes pode ser menos útil que outra menor, com origem rastreável, regras de atualização e qualidade demonstrada.
Um SGBD não garante automaticamente o desempenho ou a proteção esperada. Índices inadequados, consultas mal formuladas, credenciais privilegiadas e backups sem restauração testada podem comprometer a operação. A engenharia da solução inclui arquitetura lógica, recursos de infraestrutura, disponibilidade, segurança, monitoramento e ciclo de vida.
Dados, tabelas, registros e relacionamento
No modelo relacional, tabelas representam conjuntos de registros com atributos definidos. Chaves primárias identificam registros; chaves estrangeiras representam referências entre entidades. Restrições de unicidade, tipos e integridade referencial ajudam a impedir estados inválidos, como associar um pedido a cliente inexistente. Um modelo coerente começa pelas regras do negócio, não pela interface de consulta.
Imagine uma aplicação de manutenção com tabelas de ativos, intervenções, locais e responsáveis. Cada ativo possui identificador estável; intervenções fazem referência ao ativo e ao profissional responsável; a data e o status da atividade seguem regras de validação. Uma tabela única com todas as informações repetidas pareceria simples no início, mas poderia gerar divergências ao atualizar a localização ou o cadastro dos responsáveis.
Normalização reduz determinadas redundâncias e anomalias, porém não deve ser aplicada como dogma. Sistemas analíticos podem utilizar modelos dimensionais ou estruturas desnormalizadas por razões justificadas de consulta. O objetivo é selecionar a organização de dados adequada ao padrão de escrita, leitura, consistência e evolução do domínio.
SQL, consultas e transações
SQL é a linguagem amplamente utilizada em sistemas relacionais para consultar e modificar dados. Uma consulta SELECT seleciona linhas e colunas, aplica filtros, ordena resultados e pode combinar tabelas por JOIN. INSERT, UPDATE e DELETE modificam registros, mas devem estar submetidos a regras de autorização e integridade. O emprego de parâmetros em consultas é indispensável para reduzir riscos de SQL injection.
Uma transação agrupa operações que precisam respeitar propriedades de atomicidade, consistência, isolamento e durabilidade, normalmente conhecidas como ACID. Imagine transferir determinado recurso entre dois centros de custo: debitar um lado e creditar o outro separadamente pode causar discrepância se houver falha entre as operações. A transação cria uma fronteira para confirmar todas as mudanças previstas ou desfazê-las conforme a implementação.
Em bancos que usam Multiversion Concurrency Control, ou MVCC, transações podem observar versões de registros adequadas ao nível de isolamento. Isso ajuda no acesso concorrente, mas não significa que toda combinação de operações seja isenta de anomalias. O PostgreSQL documenta esses mecanismos e reforça a necessidade de compreender locks, níveis de isolamento e conflitos de atualização.
SQL x NoSQL: modelos e compromissos
Relacional e NoSQL não formam uma oposição simples entre sistemas antigos e modernos. Bancos documentais, chave-valor, colunares e grafos atendem padrões distintos de consulta, organização e escala. A escolha depende de relacionamentos, consultas previstas, garantias transacionais, disponibilidade, crescimento e competência operacional da equipe. Bancos relacionais também suportam dados semiestruturados, enquanto alguns sistemas NoSQL oferecem transações com escopos específicos.
| Modelo | Organização | Adequação típica | Avaliação obrigatória |
| Relacional | Tabelas e relações | Transações e entidades integradas | Índices, locks e schema |
| Documental | Documentos estruturados | Dados semiestruturados | Consistência e consultas |
| Chave-valor | Pares chave e valor | Cache e consultas simples | Expiração e persistência |
| Grafo | Nós e arestas | Relações complexas | Consultas e crescimento |
| Colunar analítico | Colunas e partições | Agregações em grandes conjuntos | Atualização e custo de consulta |
Uma escolha técnica não pode partir apenas do volume estimado de dados. A natureza dos relacionamentos e o padrão de trabalho definem a maior parte dos compromissos. Para dados de contratos, usuários, acessos e entregáveis, integridade e rastreabilidade podem ter prioridade sobre velocidade de escrita. Para telemetria massiva, retenção e ingestão contínua podem demandar particionamento ou outra tecnologia.
Infraestrutura: storage, memória, rede e disponibilidade
O banco é sensível à qualidade do armazenamento e à concorrência. IOPS, throughput, latência, cache, RAM e capacidade de CPU influenciam o tempo de resposta. A arquitetura deve prever crescimento de dados e índices, retenção de logs transacionais, manutenção e espaço para operações de backup ou recuperação. Utilização média de CPU não basta para avaliar saúde do banco.
Em alta disponibilidade, réplica não equivale automaticamente a backup. Replicação pode transportar exclusões incorretas e corrupção lógica. A equipe precisa definir o domínio de falha, o mecanismo de failover, eventual atraso da réplica, perda admissível de dados e procedimento de promoção ou retorno ao primário. Alguns mecanismos dependem de decisões para evitar que duas instâncias assumam simultaneamente a escrita.
Em uma instalação on-premises ou em cloud, a matriz de responsabilidades esclarece quem administra sistema operacional, atualizações do SGBD, storage, rede, credenciais, banco e backups. O guia de Data Center contextualiza os sistemas que sustentam essa infraestrutura.
Segurança, acesso e integridade dos dados
A política de acesso deve seguir o menor privilégio. Uma aplicação de consulta não necessita necessariamente de permissão para excluir tabelas; uma rotina de integração não deve utilizar credencial administrativa compartilhada. Contas de serviço precisam de escopo, rotação e rastreabilidade. Criptografia em trânsito e em repouso reduz determinados riscos, mas não substitui autenticação e controle de autorização.
Os dados devem ser classificados conforme sensibilidade e finalidade. Eventos de controle de acesso, registros financeiros, informações pessoais ou documentos técnicos exigem retenção, segregação e trilha de auditoria compatíveis com requisitos internos, contratuais e legais. A documentação inclui política de backup, descarte, mascaramento para testes e procedimentos de atendimento a incidentes.
Defina mecanismos de qualidade desde a entrada: tipos apropriados, campos obrigatórios, validação de domínio, deduplicação, integridade referencial e tratamento de registros rejeitados. Uma base não deve ser considerada confiável apenas porque aceita gravações sem erros. A confiabilidade se demonstra por regras verificáveis e monitoramento de anomalias.
**Construção de um modelo relacional a partir de requisitos.** Imagine uma empresa de engenharia que mantém cadastro de empreendimentos, contratos, disciplinas, documentos e revisões. Um projeto pode possuir diversos documentos, e cada documento pode ter várias revisões. Se o banco armazenar apenas o nome do arquivo em uma tabela genérica, perde-se capacidade de saber qual revisão foi aprovada, qual foi substituída e quais registros a utilizavam. A modelagem deve separar entidades duráveis, relações e histórico; definir chaves estáveis; determinar quem pode modificar estados e estabelecer restrições que impeçam aprovar duas revisões simultaneamente quando a regra do processo proíbe essa situação.
**Normalização como controle de consistência.** Repetir nome e endereço de cliente em milhares de registros aumenta a chance de atualizações divergentes. Separar cadastro do cliente de contratos e projetos reduz esse tipo de anomalia. Entretanto, normalização não é um objetivo isolado: consultas complexas podem demandar visões, índices ou modelos analíticos adicionais. O desenho precisa equilibrar integridade das operações com a eficiência de leitura, sem duplicar informação crítica de maneira descontrolada. Quando a informação é copiada para sistemas analíticos, sua origem e atualização devem permanecer identificáveis.
**Modelo lógico versus implementação física.** Uma entidade pode ser a mesma conceitualmente em dois SGBDs, mas seus tipos de dados, constraints e estratégias de indexação podem variar. A decisão física inclui escolha de precisão numérica, tratamento de horário, collation, particionamento e política de retenção. Dados financeiros devem utilizar representações numéricas adequadas, evitando erros decorrentes de ponto flutuante quando a exatidão decimal for necessária. Timestamps exigem política consistente de timezone, sobretudo quando dispositivos e usuários operam em localidades diferentes.
**Documentação e ownership do dado.** Para cada tabela relevante, defina responsável pelo significado e pelo uso, sistemas que podem escrever e políticas de classificação. Um atributo chamado status pode representar estados diferentes conforme domínio e não deve ser interpretado livremente pelos consumidores. Catálogos de dados e descrições de campos ajudam equipes a entender origem, granularidade e limitações. No ciclo de mudanças, alterar a definição de um campo pode afetar dashboards, integrações e relatórios contratuais, mesmo que a estrutura técnica permaneça inalterada.
**Qualidade na entrada e nas transformações.** Validar apenas tipo e comprimento não comprova que um dado esteja correto. Uma medição de temperatura pode estar numericamente válida e utilizar unidade incorreta; um evento de acesso pode indicar equipamento conhecido e ainda registrar horário desatualizado. O sistema deve identificar contexto, origem, regras de faixa, unidades, duplicatas e consistência temporal. Registros rejeitados precisam de tratamento e responsáveis, evitando que desapareçam silenciosamente do pipeline ou sejam corrigidos sem rastreabilidade.
Índices, otimização de consultas e planos de execução
Uma consulta lenta não significa necessariamente falta de CPU. O SGBD pode precisar percorrer grande quantidade de registros, combinar tabelas sem índices úteis, ordenar volumes extensos ou aguardar transações concorrentes. A análise deve começar pelo plano de execução, volume de linhas examinadas, seletividade dos filtros e métricas de acesso a disco. Criar índices sem medir o padrão de consultas pode aumentar o custo das gravações e o consumo de armazenamento.
Índices B-tree são recorrentes em filtros, junções e ordenações sobre valores escalares, enquanto outros métodos atendem buscas textuais, geoespaciais ou operadores específicos. A escolha depende do SGBD e do tipo de dado. O índice é um compromisso: melhora determinadas leituras, mas precisa ser atualizado em inserções, alterações e exclusões. Em sistemas com elevada taxa de escrita, multiplicar índices pode reduzir o desempenho geral.
Uma aplicação que consulta milhões de eventos por período pode se beneficiar de particionamento, índices adequados e política de retenção coerente. Entretanto, se a consulta agrega dados de dezenas de tabelas ou chama serviços externos, o gargalo pode estar na modelagem ou no aplicativo. O projeto precisa combinar perfil de consultas, métricas e testes com dados representativos.
Durante homologação, registre latência média, p95 e p99, utilização de CPU, I/O, locks e crescimento do banco. Uma mudança só deve ser aceita quando o ganho medido supera os custos de manutenção e quando o comportamento sob concorrência permanece compatível com os objetivos do serviço.
Concorrência, isolamento e conflitos de escrita
Em um ambiente multiusuário, várias transações podem ler e alterar os mesmos registros. O sistema precisa definir o nível de isolamento adequado, porque permissões de acesso não resolvem conflitos de concorrência. Operações concorrentes podem produzir leituras inconsistentes, atualizações perdidas ou resultados que não correspondem ao processo de negócio desejado se a aplicação não utilizar transações e verificações apropriadas.
Considere um sistema de reservas em que dois usuários tentam ocupar o último recurso disponível. Se ambos consultarem disponibilidade e gravarem separadamente sem mecanismo transacional adequado, o sistema pode registrar duas reservas. Restrições de unicidade, locks e níveis de isolamento podem contribuir para preservar a invariável de que o recurso tenha no máximo uma reserva ativa.
O MVCC utilizado pelo PostgreSQL permite que operações observem snapshots adequados ao isolamento configurado. Isso diminui certos conflitos de leitura e escrita, mas não elimina a necessidade de compreender anomalias e transações de longa duração. Uma operação que mantém recursos abertos por tempo excessivo pode prejudicar manutenção, consumo de espaço e desempenho.
Uma revisão técnica deve examinar os caminhos mais críticos: criação de pedidos, pagamentos, atualizações de estoque, controle de acesso e mudanças de status. Para cada um, descreva invariantes, comportamento em falha, idempotência, rollback e evidência de consistência após tentativas concorrentes.
**Escolha de índices baseada em consulta real.** Um índice acelera determinados padrões de busca, mas pode não ajudar se a consulta filtra coluna de baixa seletividade ou aplica transformação que impede seu uso. A análise exige EXPLAIN e métricas de execução no SGBD selecionado, além de estatísticas atualizadas. Índices compostos precisam considerar ordem das colunas, seletividade e filtros usuais. A criação excessiva aumenta tempo de escrita e espaço de armazenamento, especialmente em tabelas com ingestão intensa de eventos.
**Particionamento e retenção de dados históricos.** Grandes volumes de eventos podem ser particionados por tempo, local ou outra dimensão justificada. Isso pode simplificar descarte de períodos antigos e reduzir o conjunto de dados consultado em determinadas operações. Porém, a escolha da chave afeta distribuição de carga, índices e queries. Um plano de retenção exige verificar requisitos legais, contratuais e investigativos antes de apagar partições. O desenho também deve incluir arquivamento ou transferência para plataforma analítica quando necessário.
**Controle de concorrência orientado ao processo.** Locks e transações devem proteger invariantes do negócio, não simplesmente evitar erros técnicos. Uma plataforma que reserva equipamentos para equipes não pode permitir duas reservas exclusivas simultâneas. Uma sequência de leituras e gravações sem isolamento adequado pode produzir decisão baseada em estado antigo. Os testes precisam executar operações concorrentes e observar conflitos, cancelamentos e retries. A equipe deve distinguir situações de bloqueio legítimo, deadlock e lentidão causada por transações excessivamente longas.
**Escalabilidade de leitura e escrita.** Aumento de usuários pode justificar cache, pool de conexões, réplica de leitura ou reestruturação de consultas. Cada alternativa impõe compromissos: cache exige invalidação, réplica pode apresentar atraso, e ampliação do pool pode aumentar pressão sobre CPU ou memória do banco. É necessário avaliar end-to-end latency, consumo do sistema completo e consistência exigida. Melhorar apenas o indicador de uma consulta sintética não comprova ganho no processo de negócio.
**Roteiro de diagnóstico de desempenho.** Quando um sistema fica lento, investigue planos de execução, conexões, locks, utilização de buffer, I/O, queries mais custosas, crescimento e alterações recentes. Evite iniciar pela compra de hardware: um índice inadequado ou consulta sem filtro pode consumir toda a capacidade disponível. O registro do incidente deve documentar evidências, hipótese, ajuste e teste de regressão. Essas análises sustentam planejamento de capacidade e previnem recorrência de problemas.
Integração com APIs, eventos e sistemas corporativos
Dados corporativos circulam entre ERP, CRM, plataformas de gestão, sensores, controle de acesso e Business Intelligence. O banco transacional de uma aplicação não deve ser transformado indiscriminadamente em ponto de leitura direta para todos os outros sistemas. Essa prática pode comprometer desempenho, expor informações sensíveis e criar dependência sobre um schema que muda de acordo com necessidades internas.
Uma camada de integração pode expor APIs, eventos ou extratos controlados que preservem o contrato entre sistemas. Event-driven integration ajuda a distribuir mudanças, mas exige identificadores, timestamps, política de reprocessamento e consistência entre publicação do evento e commit da transação. Padrões como outbox transacional são alternativas para reduzir discrepâncias quando gravação e emissão de eventos precisam ser coordenadas.
Para Business Intelligence, os dados podem ser extraídos e transformados por pipelines, sem obrigar consultas pesadas sobre o banco operacional durante horários críticos. O [guia de Business Intelligence](https://a3aengenharia.com.br/conteudo/guias-tecnicos/guia-completo-business-intelligence-arquitetura-dados-governanca/) discute a consolidação de fontes e o tratamento dos indicadores. A arquitetura de dados é complementar à discussão sobre o que é um banco e como manter sua integridade.
A interface deve estabelecer qualidade, responsabilidade e temporalidade. Um dashboard atualizado de hora em hora não oferece a mesma visão operacional que um serviço transacional. Essa diferença precisa ser explicitada, evitando decisões fundamentadas em dados atrasados apresentados como se fossem informações em tempo real.
Backup, alta disponibilidade e recuperação testada
A proteção de um banco exige definir RPO, RTO, retenção, política de cópias e consistência do método de backup. Copiar indiscriminadamente arquivos de um banco em operação pode resultar em conjunto inconsistente. O procedimento precisa utilizar ferramentas suportadas pelo SGBD, logs de transação quando aplicável e testes de restauração que verifiquem integridade de tabelas e funcionamento da aplicação.
Replicação reduz determinados tempos de recuperação, mas não protege automaticamente contra exclusão acidental ou corrupção lógica. Uma réplica pode receber os mesmos erros enviados ao primário. Cópias independentes com controles de imutabilidade, segregação ou armazenamento offline são medidas a avaliar conforme criticidade e cenário de ataque.
Um teste de recuperação não termina quando o serviço de banco inicializa. A equipe precisa validar aplicações consumidoras, permissões, integridade de dados, versões de schema, certificados e dependências. Em ambientes com múltiplos bancos, a sequência de recuperação pode impactar consistência entre sistemas, sendo necessário definir checkpoints e procedimentos de reconciliação.
O resultado deve gerar evidências: qual backup foi restaurado, quanto tempo a operação levou, quais registros foram verificados e se o RPO e o RTO foram atendidos. Sem esses elementos, a política de continuidade permanece uma hipótese não demonstrada.
Modelagem de dados e evolução do schema
Um modelo de dados precisa expressar o domínio de negócio, e não apenas reproduzir os campos de um formulário. Identifique entidades, eventos, atributos, regras de integridade, chaves e cardinalidades. A modelagem conceitual ajuda a discutir com responsáveis pelo processo; a modelagem lógica organiza tabelas e relações; a implementação física considera índices, particionamento, tipos e recursos do SGBD. Alterações precisam passar por análise de impacto porque diferentes aplicações podem depender do mesmo esquema.
Em ambientes que evoluem continuamente, migrations devem ser versionadas e testadas com dados representativos. Renomear uma coluna usada por vários sistemas ou alterar seu tipo sem plano de compatibilidade pode interromper integrações. Uma estratégia gradual cria novos campos, adapta consumidores, migra dados e somente depois elimina estruturas obsoletas. Esse cuidado reduz riscos em operação 24×7.
**Tratamento de dados ausentes.** Um campo sem preenchimento pode significar informação desconhecida, não aplicável ou ainda não coletada. Essas condições não são equivalentes e podem exigir atributos de status ou regras próprias. Confundir valor zero com informação ausente distorce cálculos e indicadores. Uma arquitetura de dados robusta define semântica de campos nulos, padrões de preenchimento e validação para impedir que informações incompletas pareçam corretas em relatórios.
**Dicionário de dados e metadados.** Os nomes das colunas não bastam para orientar consumidores. O dicionário deve documentar significado, unidade, formato, fonte, periodicidade, proprietário e restrições. Em integração com equipamentos de campo, metadados identificam local, dispositivo e versão da configuração. Sem esses elementos, a empresa pode comparar medições que utilizam diferentes unidades ou eventos que representam condições operacionais distintas.
**Regras de retenção e descarte.** Nem todo dado precisa permanecer indefinidamente na base operacional. O projeto deve classificar registros conforme necessidade de negócio, obrigações legais e valor histórico, definindo política de retenção, arquivamento e exclusão. Expirar dados sem analisar dependências pode comprometer auditorias; manter tudo para sempre aumenta custo e exposição. A decisão precisa ser formalizada, testada e auditável.
**Dados mestres e sistemas de referência.** Quando cliente, equipamento ou unidade organizacional existe em várias aplicações, é necessário estabelecer qual sistema tem autoridade para cada atributo. Sincronizações bidirecionais sem essa regra podem criar conflitos e sobrescrever informações corretas. Identificadores compartilhados, contratos de integração e procedimentos de reconciliação reduzem divergências, preservando a possibilidade de corrigir dados na origem.
Qualidade, governança e ciclo de vida da informação
O banco preserva valores que recebe, mas não garante que eles representem fatos corretos. Qualidade depende de controles de completude, consistência, validade, unicidade e atualidade. Um cadastro pode cumprir todas as restrições técnicas e continuar apresentando local incorreto, responsável desatualizado ou unidades incompatíveis. É necessário estabelecer quem produz, valida, aprova e corrige cada classe de informação.
O ciclo de vida também precisa tratar retenção e descarte. Logs operacionais, documentos, eventos de segurança e registros de usuários possuem finalidades diferentes. A política deve definir por quanto tempo cada informação permanece disponível, como é arquivada e como são atendidos pedidos e obrigações aplicáveis. Essas decisões interferem em capacidade de armazenamento, backup, desempenho e custo.
Banco de dados transacional e banco analítico
Sistemas transacionais são construídos para manter operações de negócio corretas sob concorrência, enquanto plataformas analíticas frequentemente priorizam leitura de grandes conjuntos, agregação e histórico. Essa distinção ajuda a explicar por que um ERP e um Data Warehouse podem utilizar modelos diferentes sem que um esteja tecnicamente errado. O desenho analítico pode reunir dados de várias fontes, corrigir qualidade e apresentar indicadores por período.
Permitir que relatórios muito pesados concorram com transações críticas no mesmo ambiente pode degradar a operação. Réplicas de leitura, pipelines e plataformas analíticas são opções que precisam ser avaliadas por carga, latência admissível e consistência. Um dashboard não pode prometer informação instantânea quando depende de atualização noturna; a temporalidade é parte do contrato do dado.
**Transações financeiras e integridade de negócio.** Uma plataforma de gestão contratual pode registrar empenhos, pagamentos, retenções e ajustes. A gravação de apenas uma parte dessas operações pode produzir saldos incorretos. O projeto deve identificar quais mudanças precisam ocorrer dentro de uma transação e quais podem ser executadas de maneira assíncrona, preservando identificadores para reconciliação. Restrições de integridade e regras de autorização precisam ser aplicadas no banco e na aplicação conforme o contexto. Logs de auditoria devem permitir reconstruir quem executou cada alteração e quais parâmetros eram válidos naquele momento.
**Controle de mudanças em schema.** A publicação de uma nova versão da aplicação pode exigir novas colunas ou tabelas. Se outros serviços dependem do schema anterior, a mudança precisa preservar compatibilidade durante o período de transição. Estratégias de expand-and-contract podem criar uma estrutura nova, adaptar leitores e escritores e só depois remover o campo antigo. Antes da mudança, a equipe deve testar migrations com volume representativo, medir duração dos bloqueios e preparar plano de reversão que não pressuponha recuperação impossível de dados já modificados.
**Sincronização e captura de alterações.** Sistemas integrados podem usar eventos, APIs ou Change Data Capture (CDC) para propagar mudanças. O mecanismo deve definir ordem, reprocessamento, identificadores e eventual atraso. Uma atualização que chega duas vezes não pode gerar duas operações de negócio quando seu significado é único. A arquitetura de dados precisa registrar quais informações são referência, quais são cópias de leitura e como divergências são reconciliadas. Essa distinção é especialmente importante quando um banco alimenta sistemas de Business Intelligence, automação e plataformas de segurança eletrônica.
**Proteção de dados sensíveis.** Dados pessoais, credenciais e informações de sistemas críticos exigem classificação e segregação. O SGBD pode limitar leitura por função, mas permissões de aplicação, acesso administrativo, replicação, exportação e backup também compõem a superfície de exposição. Uma base restaurada em homologação pode conter os mesmos dados sensíveis da produção; por isso, anonimização ou mascaramento deve ser avaliado antes de testes. A engenharia deve definir quais registros são indispensáveis e estabelecer política de retenção que considere finalidade e obrigações aplicáveis.
**Planejamento de suporte e continuidade.** A solução precisa de responsável por atualização, performance, backup, recuperação e incidentes. Bancos com suporte encerrado ou documentação incompleta representam risco crescente. A matriz de responsabilidades deve registrar o papel do provedor, administrador, desenvolvedor e proprietário dos dados, especialmente em serviços gerenciados. Testes periódicos de recuperação demonstram se os objetivos de continuidade continuam atendidos após crescimento do acervo e modificações na arquitetura.
Monitoramento e incidentes em bancos de dados
A observabilidade precisa cobrir saturação, erros de conexão, deadlocks, bloqueios, latência de consulta, crescimento de tabelas, utilização de índices, I/O e espaço livre. Alertas genéricos de CPU não identificam necessariamente degradação da aplicação. É importante relacionar consultas às funcionalidades de negócio, rastrear mudanças recentes e definir limiares coerentes com o nível de serviço.
Um incidente de banco pode decorrer de uma migration, consulta sem filtro, aumento de conexões, falta de espaço ou falha de armazenamento. O procedimento de resposta deve diferenciar causa raiz e sintoma, preservar evidências e registrar o impacto. Reiniciar o SGBD repetidamente sem diagnóstico pode ampliar a indisponibilidade e comprometer a investigação.
**Capacidade em cenários de carga variável.** Para dimensionar um banco, levante usuários simultâneos, conexões, consultas complexas, operações de escrita, volume de arquivos e evolução temporal. Uma média mensal de transações não descreve picos durante fechamento financeiro ou consolidação de indicadores. É necessário testar simultaneidade, contenção e tempos de resposta. A capacidade instalada deve incluir reserva operacional e comportar atividades de manutenção, réplicas e backups sem comprometer funções críticas.
**Critérios de segurança no projeto executivo.** A documentação deve especificar segmentação de rede, autenticação, criptografia em trânsito, administração privilegiada, rotação de credenciais e integração com monitoramento. O princípio de menor privilégio deve ser aplicado a usuários e contas de serviço. É importante verificar também caminhos indiretos de acesso por relatórios, exports, integrações e sistemas que armazenam credenciais. Uma API segura não compensa uma base exposta a todas as estações da rede.
**Observabilidade de transações e serviços.** Métricas do banco precisam ser relacionadas com o funcionamento da aplicação. Latência de consulta, espera por lock, taxa de erro, saturação de storage e consumo de conexões ajudam a localizar gargalos. Entretanto, o indicador final deve representar uma função do negócio: registrar uma ordem, consultar um contrato ou confirmar um evento. Instrumentação que correlaciona a requisição com a consulta ao banco permite distinguir problema na aplicação, na rede ou no armazenamento.
**Comissionamento e recuperação operacional.** Os testes devem verificar operações válidas e inválidas, concorrência, integridade referencial, segurança e persistência. Simular queda do banco durante uma transação ajuda a demonstrar comportamento de rollback e retry. Restaurar backup em ambiente isolado permite medir perda de dados e tempo de recuperação. Os resultados precisam ser apresentados com evidência, responsável e parecer de aceite; uma captura de tela de serviço iniciado não comprova que o negócio poderá operar após incidente.
**Transferência para a equipe operacional.** A implantação deve terminar com documentação as-built, inventário, política de versões, rotina de manutenção, scripts de recuperação, alertas e matrizes de permissões. A equipe precisa conseguir identificar status, executar tarefas autorizadas e escalar incidentes sem depender da memória de quem desenvolveu a aplicação. Um banco tecnicamente sofisticado, mas impossível de restaurar ou auditar por seus operadores, não está pronto para suportar sistemas críticos.
**Confiabilidade de consultas corporativas.** Uma base que sustenta múltiplos relatórios deve possuir definições claras de indicadores e filtros. A mesma expressão, como contratos ativos, pode considerar datas, status e regras diferentes em cada área. O banco precisa preservar os dados necessários para uma interpretação consistente, mas a definição do indicador pertence ao processo de negócio. Documentar fórmulas, granularidade e atualização evita que consultas tecnicamente corretas produzam interpretações divergentes.
**Validação de restauração após corrupção lógica.** A existência de backup não garante que a informação possa ser recuperada ao ponto pretendido. O teste deve considerar exclusão indevida, atualização incorreta e corrupção replicada, além de falhas físicas. A equipe precisa verificar se há retenção suficiente, logs de transação apropriados e procedimento para restaurar em ambiente separado sem sobrescrever a produção. A recuperação também requer conciliação das operações realizadas após o ponto escolhido.
**Migrations e reversão de schema.** Quando uma nova versão altera tabelas, tipos ou constraints, a mudança deve ser homologada com volume representativo. Em bancos grandes, determinados comandos podem exigir locks ou consumir espaço temporário relevante. O plano de implantação precisa determinar janela, forma de acompanhamento, critério de interrupção e tratamento de versões antigas da aplicação. Um rollback que apenas restaura binários pode falhar quando os dados já passaram por transformação irreversível.
**Isolamento entre produção e homologação.** Bases de teste devem utilizar dados adequadamente protegidos e credenciais independentes. Copiar integralmente registros de clientes para um ambiente menos seguro pode criar exposição desnecessária. Estratégias de anonimização ou geração de dados sintéticos precisam preservar propriedades relevantes ao teste sem reproduzir informação sensível além do necessário. A homologação deve medir também comportamento de carga e concorrência, não apenas confirmar que a aplicação inicia.
**Capacidade de auditoria de operações.** Registros de acesso, mudanças de permissões, alterações críticas e exportações relevantes devem ser rastreáveis. Isso permite investigar problemas e demonstrar cumprimento de políticas. Ao mesmo tempo, logs devem evitar gravação de senhas, tokens ou dados pessoais excessivos. Retenção, acesso aos registros e proteção contra alterações precisam ser definidos como parte da solução e avaliados durante o aceite técnico.
**Disponibilidade do serviço completo.** Um SGBD pode estar ativo enquanto a aplicação não consegue se autenticar ou executar sua consulta principal. Portanto, critérios de aceite devem incluir transações end-to-end e dependências de rede, identidade, storage e aplicação. A redundância do banco não elimina componentes únicos de falha situados fora dele. Simulações de indisponibilidade precisam verificar comportamento para usuários, não apenas o estado de réplicas ou serviços internos.
**Transição e documentação operacional.** O projeto precisa entregar modelo lógico, matriz de privilégios, política de retenção, rotinas de backup, inventário de integrações, parâmetros críticos e procedimento de resposta a incidentes. A equipe que manterá o sistema deve participar dos ensaios e aprovar a transferência. Sem documentação, a continuidade fica condicionada ao conhecimento informal de quem implantou o banco, mesmo que a infraestrutura seja tecnicamente moderna.
Como contratar, testar e aceitar uma solução de dados
O termo de referência deve apresentar volume inicial e crescimento previsto, quantidade de usuários, padrões de consulta, requisitos de integridade, retenção, segurança, disponibilidade, recuperação e integração. O projeto executivo define modelo lógico, índices, topologia, perfis de acesso, mecanismos de backup, monitoramento e rotinas de manutenção. Critérios subjetivos como banco robusto não substituem testes mensuráveis.
Na homologação, execute cargas representativas, testes de concorrência, migrações de schema, falhas de rede e recuperação de backups. Documente o resultado esperado, a medida observada e o responsável pela aprovação. O aceite não deve se limitar a instalar o SGBD: precisa demonstrar que as aplicações consultam e modificam dados corretamente, mesmo sob falhas previstas.
**Planos de execução e evidência técnica.** Antes de promover um ajuste de performance, registre consultas representativas, número de registros, cardinalidade, índices existentes e recursos do host. Compare o plano de execução antes e depois da mudança e observe se o ganho se mantém com parâmetros e cargas diferentes. Um índice que acelera uma consulta de demonstração pode aumentar o custo de gravação ou não ser utilizado em produção por baixa seletividade. As decisões devem ser baseadas em perfis medidos e documentados.
**Testes de recuperação de desastre.** O plano precisa simular perda de storage, falha lógica e restauração em infraestrutura alternativa. A validação não termina na importação dos dados: deve incluir integridade referencial, reconexão da aplicação, permissões e transações representativas. Registre diferença entre horário do último dado recuperado e horário da falha, tempo de recuperação total e pendências de reconciliação. Esses dados permitem verificar cumprimento real de RPO e RTO.
**Monitoramento de crescimento de tabelas e índices.** Bancos operacionais acumulam dados e estruturas auxiliares que podem crescer em ritmos distintos. O projeto deve medir ocupação, fragmentação, retenção de logs, histórico e alterações de comportamento das consultas. Capacidade de storage precisa contemplar backup, manutenção, reindexação e expansão, evitando dimensionar apenas o tamanho bruto dos registros. A decisão de arquivar dados deve considerar consultas históricas e obrigações de preservação.
**Controle de privilégios em ambientes distintos.** Desenvolvimento, homologação e produção não devem compartilhar credenciais administrativas por conveniência. A equipe deve separar perfis, registrar aprovações e limitar acesso aos dados reais. Scripts de migração e processos de integração precisam utilizar permissões compatíveis com sua finalidade. Um vazamento de credencial de aplicação não deveria permitir alterar toda a estrutura do banco ou acessar indiscriminadamente informações de outras unidades.
Exemplo aplicado: gestão de ativos e manutenção
Em um empreendimento com equipamentos elétricos, CFTV, controle de acesso e redes, diferentes equipes precisam consultar ativos, localizar equipamentos, registrar inspeções e acompanhar intervenções. Um modelo relacional pode representar ativos, locais, componentes, ocorrências, ordens de serviço e profissionais por identificadores estáveis. Os registros de manutenção precisam manter a referência ao equipamento correto mesmo quando o nome comercial ou a localização descritiva do ativo muda.
O projeto define quais informações são mestre, quem pode editá-las e quais operações exigem trilha de auditoria. Uma ordem de serviço encerrada não deve desaparecer quando o usuário responsável é desativado. A integridade referencial e a política de histórico devem preservar o vínculo com os fatos documentados. Dados coletados em campo precisam registrar origem, instante e condição de validação, especialmente quando há sincronização posterior de dispositivos offline.
Na integração com dashboards, alguns campos podem ser consolidados por período e por instalação, enquanto os eventos originais continuam preservados no banco operacional. O resultado deve permitir responder não apenas quantas falhas ocorreram, mas quais equipamentos foram afetados, quem registrou o incidente e quais ações foram executadas. Sem modelagem adequada, os indicadores podem ser visualmente atraentes e tecnicamente inconsistentes.
**Integridade em sistemas com eventos externos.** Dados recebidos de câmeras, sensores ou controladoras podem chegar repetidos ou fora de ordem. O banco precisa de regras de identificação e deduplicação adequadas ao domínio. Uma ocorrência pode ter timestamp do equipamento e outro da chegada ao servidor; a consulta deve esclarecer qual deles é usado no indicador. Sem essa disciplina, métricas de acesso, ocupação ou desempenho podem ser afetadas por atrasos de sincronização e falhas de comunicação.
**Governança de mudanças entre equipes.** Quando uma tabela atende a vários sistemas, alterações de schema precisam ser anunciadas e testadas pelos consumidores. Contratos de dados e políticas de versionamento reduzem risco de incompatibilidade. A mudança deve ter autor, justificativa, versão, plano de implantação e reversão. Mesmo uma alteração considerada interna pelo fornecedor pode ter impacto significativo sobre integrações e relatórios mantidos por outros responsáveis.
**Análise de segurança e conformidade.** Um inventário de dados deve apontar categorias sensíveis, finalidade de uso, base de autorização quando aplicável, política de retenção e indivíduos ou sistemas com acesso. Backups e exportações fazem parte desse inventário, pois podem conter cópias completas de registros pessoais e operacionais. Controles de segurança devem ser verificados por testes, revisões de permissões e registros de auditoria, não apenas pela existência de uma política escrita.
**Critérios de aprovação da arquitetura.** A decisão entre SGBD relacional, documental, serviço gerenciado ou instalação própria deve gerar um registro técnico com requisitos, alternativas, riscos, custos e testes. Se a escolha depende de determinado fornecedor, identifique mecanismos de exportação e migração. Se depende de equipe especializada, considere treinamento e suporte. A arquitetura deve ser suficiente para a demanda esperada e viável de manter quando crescer ou sofrer falhas.
Trade-offs de SQL, NoSQL e bancos gerenciados
A seleção tecnológica deve considerar exigências de consulta, ecossistema, licenciamento, suporte, disponibilidade de profissionais e capacidade de recuperação. Em um projeto relacional, utilizar o SGBD amplamente conhecido pela equipe pode ser melhor do que adotar mecanismo especializado sem justificativa. Em outros cenários, um banco documental ou de séries temporais pode simplificar ingestão e reduzir o esforço de transformação.
Bancos gerenciados transferem parte das atividades de infraestrutura ao fornecedor, mas não eliminam obrigações de modelagem, controle de acesso, qualidade, observabilidade e configuração. A matriz contratual deve descrever quem executa backups, quem pode restaurar dados, quais parâmetros são gerenciados e como ocorre a saída para outro provedor. O preço mensal isolado não revela custos de tráfego, armazenamento, retenção, réplicas e suporte.
A prova de conceito deve incluir consultas reais e falhas previsíveis. Se uma alternativa apresenta desempenho muito superior apenas em teste sintético, investigue a representatividade dos dados e a complexidade de manutenção. O objetivo é escolher uma arquitetura confiável e sustentável no ciclo de vida, não maximizar uma única métrica de laboratório.
**Indicadores de maturidade operacional.** Além de disponibilidade do SGBD, acompanhe sucesso de backups, tempo de recuperação testado, incidentes por alteração de schema, taxa de falhas de consulta, crescimento de armazenamento e proporção de dados inválidos. Esses indicadores mostram se a tecnologia sustenta efetivamente a operação. O conjunto deve ser proporcional à criticidade: uma base de cadastro simples não precisa da mesma infraestrutura de uma plataforma transacional institucional.
**Economia e valor de ciclo de vida.** A seleção não se encerra no licenciamento ou na escolha entre cloud e servidores locais. A análise deve incluir administração, energia, conectividade, backup, monitoramento, suporte, treinamento, atualização e eventual migração. Plataformas especializadas podem simplificar determinados workloads, mas criam requisitos próprios de conhecimento e operação. A melhor alternativa é aquela que atende necessidades mensuráveis com riscos e custos justificáveis.
**Interoperabilidade e continuidade.** Uma base isolada pode executar consultas rapidamente e ainda produzir pouco valor se os dados não forem integráveis. O projeto deve privilegiar contratos de dados, APIs controladas, versionamento e exportação em formatos adequados. Ao mesmo tempo, a interoperabilidade não deve abrir acesso indiscriminado a tabelas internas. A fronteira entre operação e consumo precisa ser documentada.
**Conclusão técnica aplicada.** O banco de dados deve ser tratado como componente de um sistema de engenharia com requisitos, interfaces, evidências e responsáveis. A confiabilidade decorre da interação entre modelagem correta, controles de integridade, infraestrutura, segurança e operação. Essa visão permite utilizar informações para gestão, fiscalização, manutenção e Business Intelligence sem transformar dados de origem desconhecida em decisões não verificáveis.
Considerações finais
Banco de dados é parte da arquitetura de informação corporativa. Um bom modelo depende de regras do domínio, relacionamentos corretos, transações consistentes, segurança, índices adequados e infraestrutura capaz de atender à carga. SQL, NoSQL e sistemas analíticos oferecem escolhas complementares, não uma hierarquia universal de qualidade.
Uma decisão consistente transforma requisitos de negócio em projeto, operação e critérios mensuráveis. A capacidade de recuperar dados, auditar mudanças e evoluir sistemas ao longo do tempo é tão importante quanto a velocidade de executar uma consulta.
Referências técnicas
[1] PostgreSQL Global Development Group. PostgreSQL Documentation — MVCC Introduction. Disponível em: https://www.postgresql.org/docs/current/mvcc-intro.html.
[2] PostgreSQL Global Development Group. PostgreSQL Documentation — Transaction Isolation. Disponível em: https://www.postgresql.org/docs/current/transaction-iso.html.
[3] SQLite. SQLite — Isolation in SQLite. Disponível em: https://sqlite.org/isolation.html.
[4] OWASP. SQL Injection Prevention Cheat Sheet. Disponível em: https://cheatsheetseries.owasp.org/cheatsheets/SQL_Injection_Prevention_Cheat_Sheet.html.
Perguntas frequentes
É uma organização estruturada de informações com regras de consulta, atualização e integridade.
É o software que administra armazenamento, consultas, transações, acesso e recuperação dos dados.
Não. Planilhas e bancos podem armazenar dados, mas diferem em concorrência, integridade e gerenciamento.
É um atributo ou conjunto de atributos que identifica de modo único um registro.
É uma referência a registro de outra tabela, sujeita às regras definidas pelo modelo.
SQL é comumente associado ao modelo relacional; NoSQL reúne modelos como documental e chave-valor, cada um com compromissos próprios.
É uma operação lógica sujeita a propriedades de atomicidade, consistência, isolamento e durabilidade.
Exige método compatível com o SGBD, retenção, proteção e teste de restauração.
Não. Replicação pode propagar erros, exclusões e corrupção lógica.
É uma estrutura que pode acelerar certos acessos, mas exige manutenção, espaço e avaliação das consultas.